Linux C 语言学习笔记:从开发环境到 GCC
从 Ubuntu 开发环境、数据类型与控制流程,到指针、内存布局、结构体和 GCC 的一份完整学习笔记。
本文由《C语言.docx》课程笔记整理为一篇可继续编辑的 Markdown 文章。示例、术语与配图均保留原始学习顺序;其中的练习题可作为复习清单使用。
01-飞秋的使用
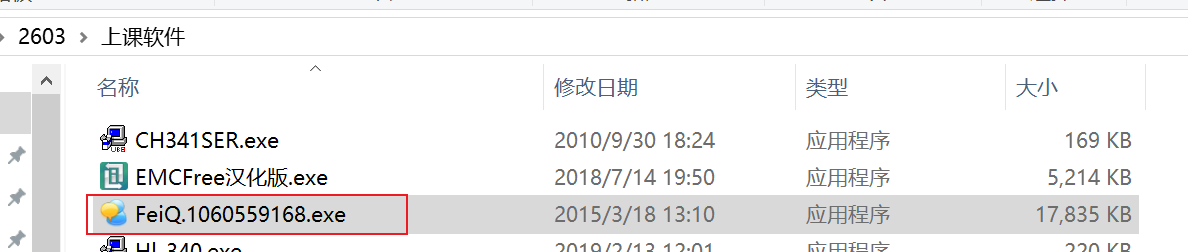
飞秋是一个局域网,文件传输工具,在同一个局域网内,可以共享自己的文件夹和文件,
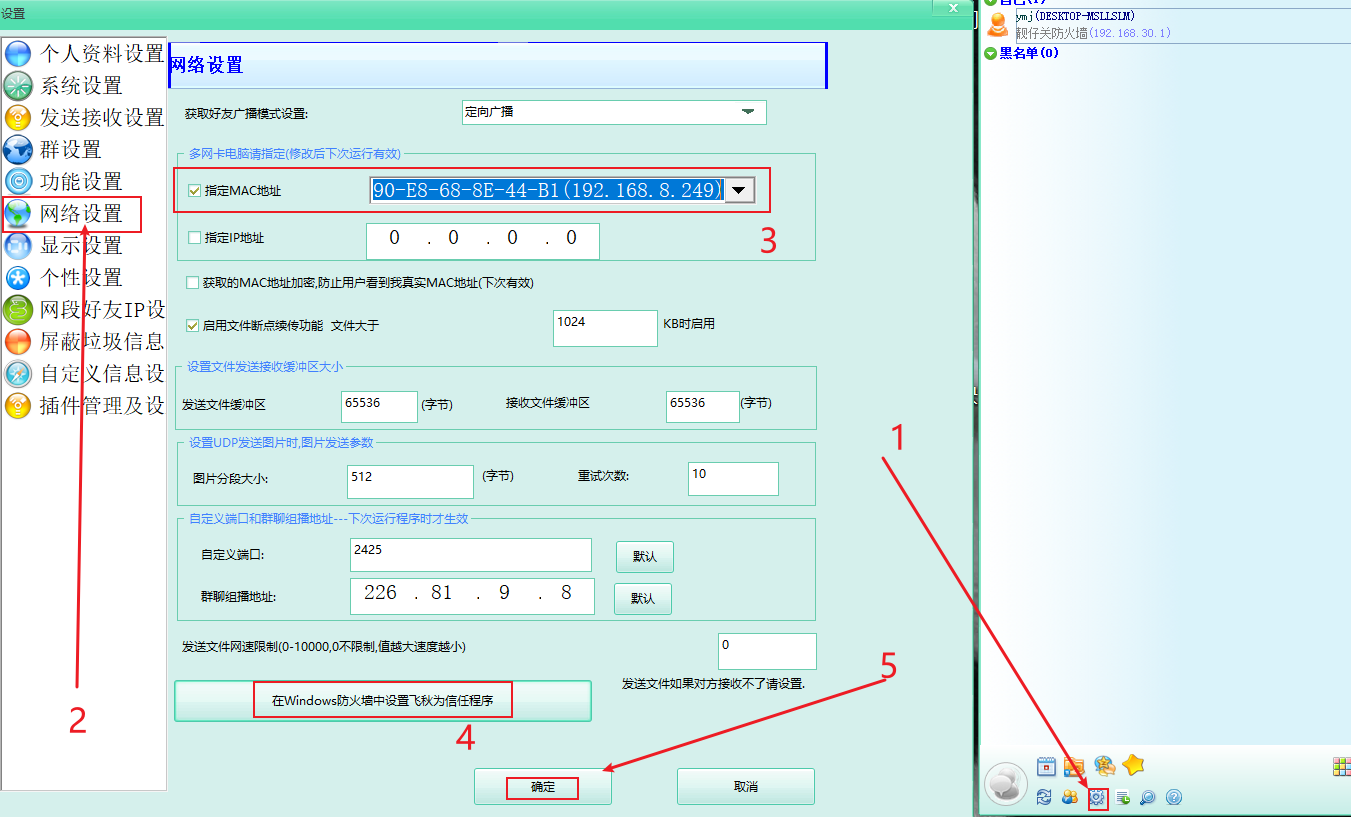
配置飞秋的IP地址
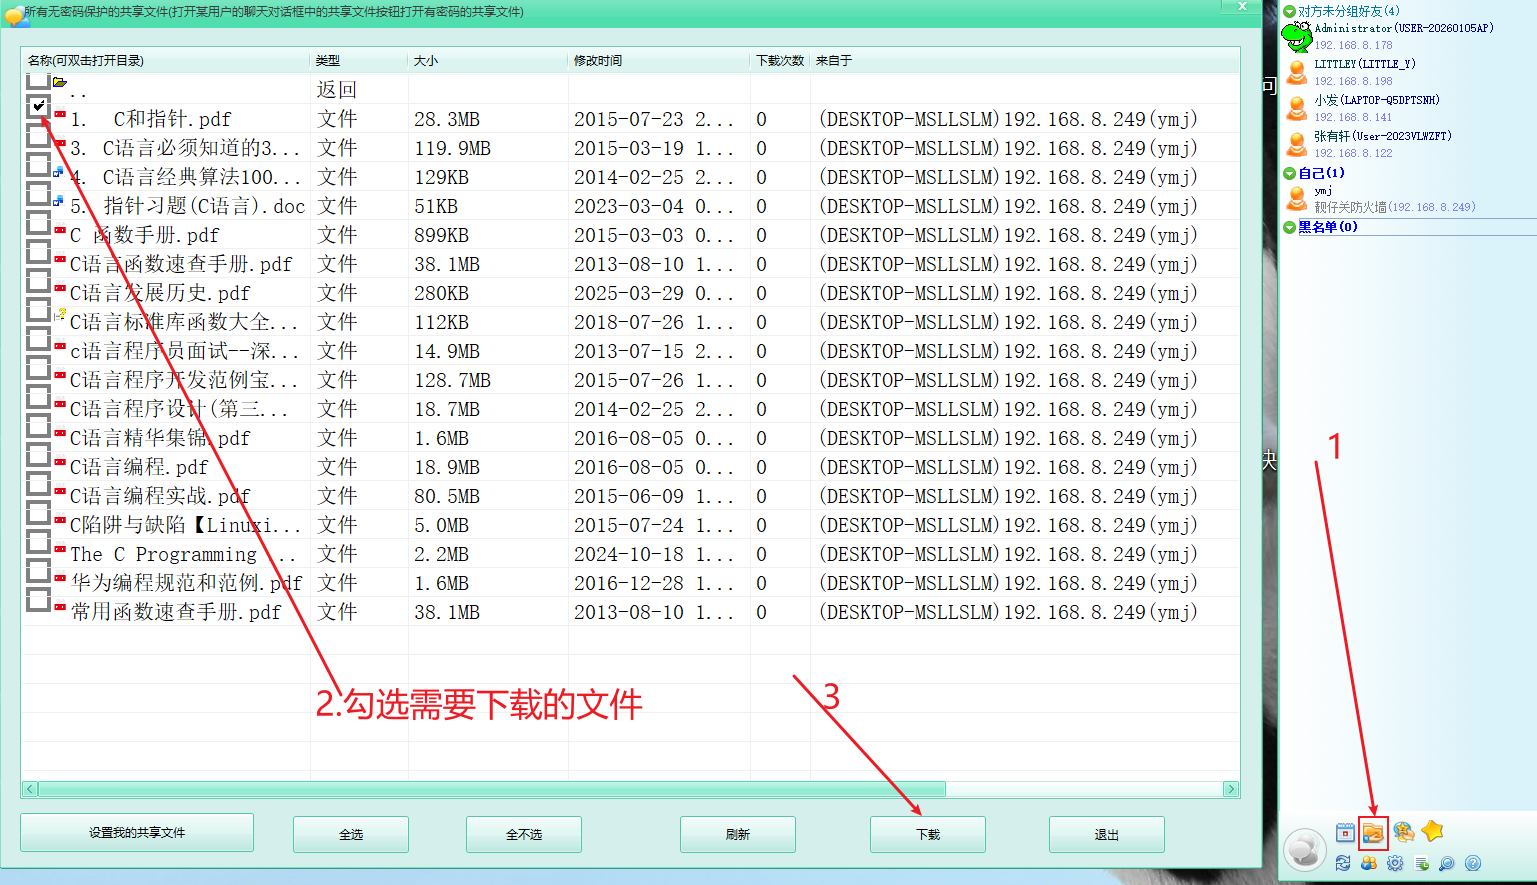
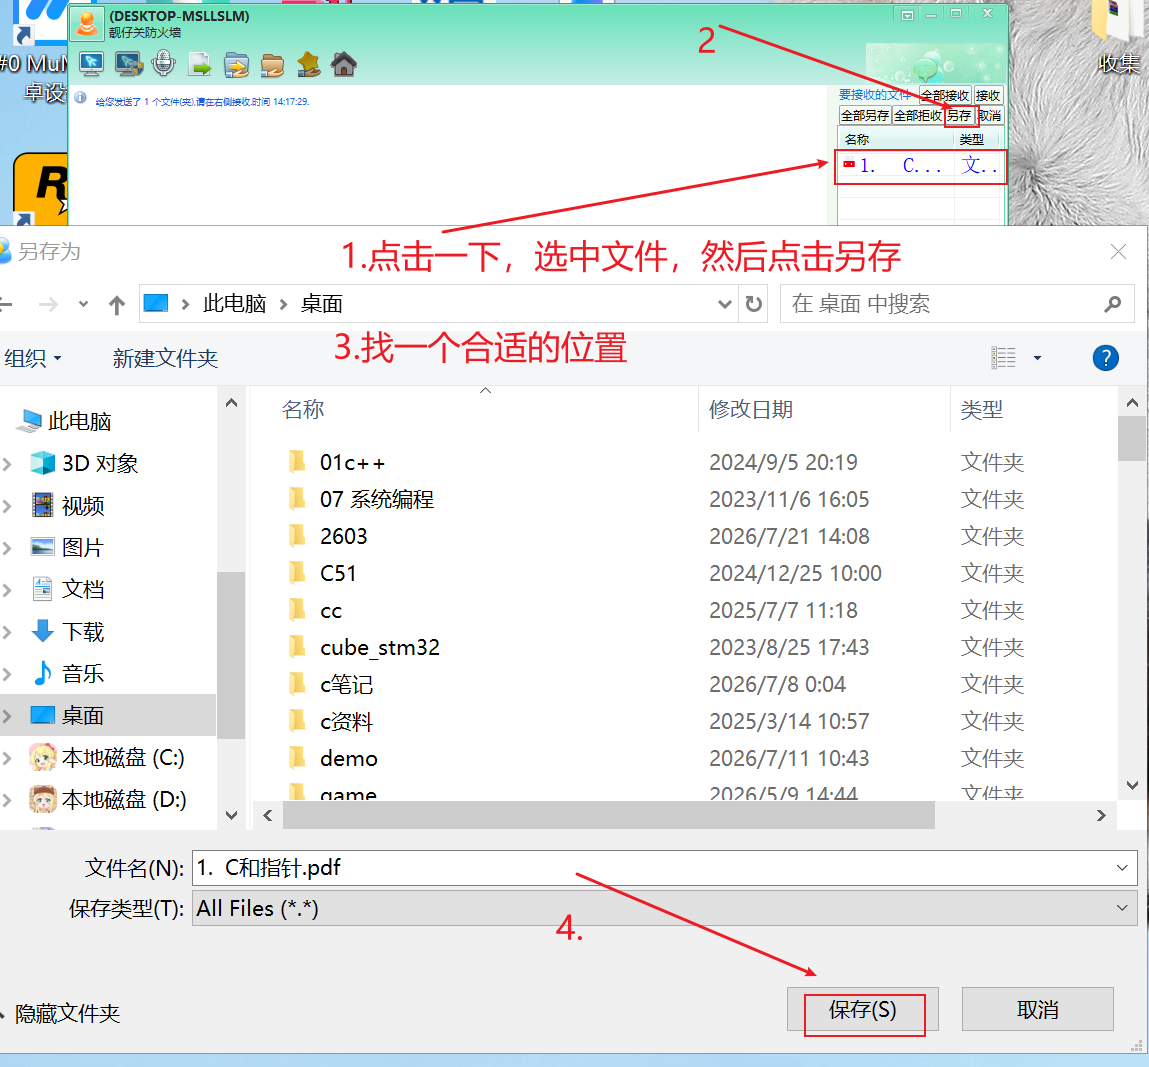
下载共享文件
02-上课环境
VMware+Ubuntu+vscode
虚拟机在现有的电脑硬件资源基础上,模拟一个新的电脑环境,然后Ubuntu是拥有Linux内核的操作系统,vscode是一款微软出品的,拥有非常丰富插件的代码编辑工具
03-Ubuntu的常见快捷方式
界面的放大和缩小
`Ctrl+Shift+'+'`
`Ctrl+'-'`
打开新的终端
`Ctrl+Alt+T`
`Ctrl+Shift+N` 打开和上一次选中的终端相同的路径的终端
`Ctrl+Shift+C` 复制,`Ctrl+Shift+V` 粘贴
鼠标滚轮也是粘贴,
在Ubuntu中,选中默认复制
设置锁屏时间
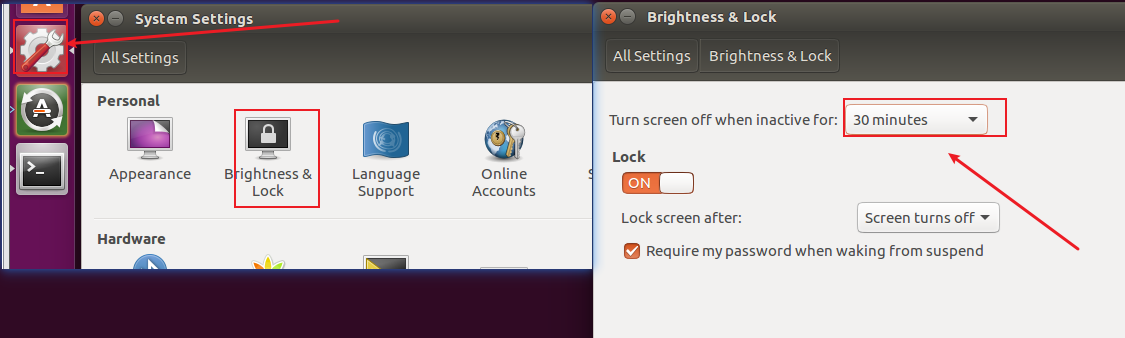
04-共享文件夹设置
因为Linux和Windows是两个不同的操作系统,所以彼此有文件隔离,那么要操作同一个文件,需要配置共享文件夹
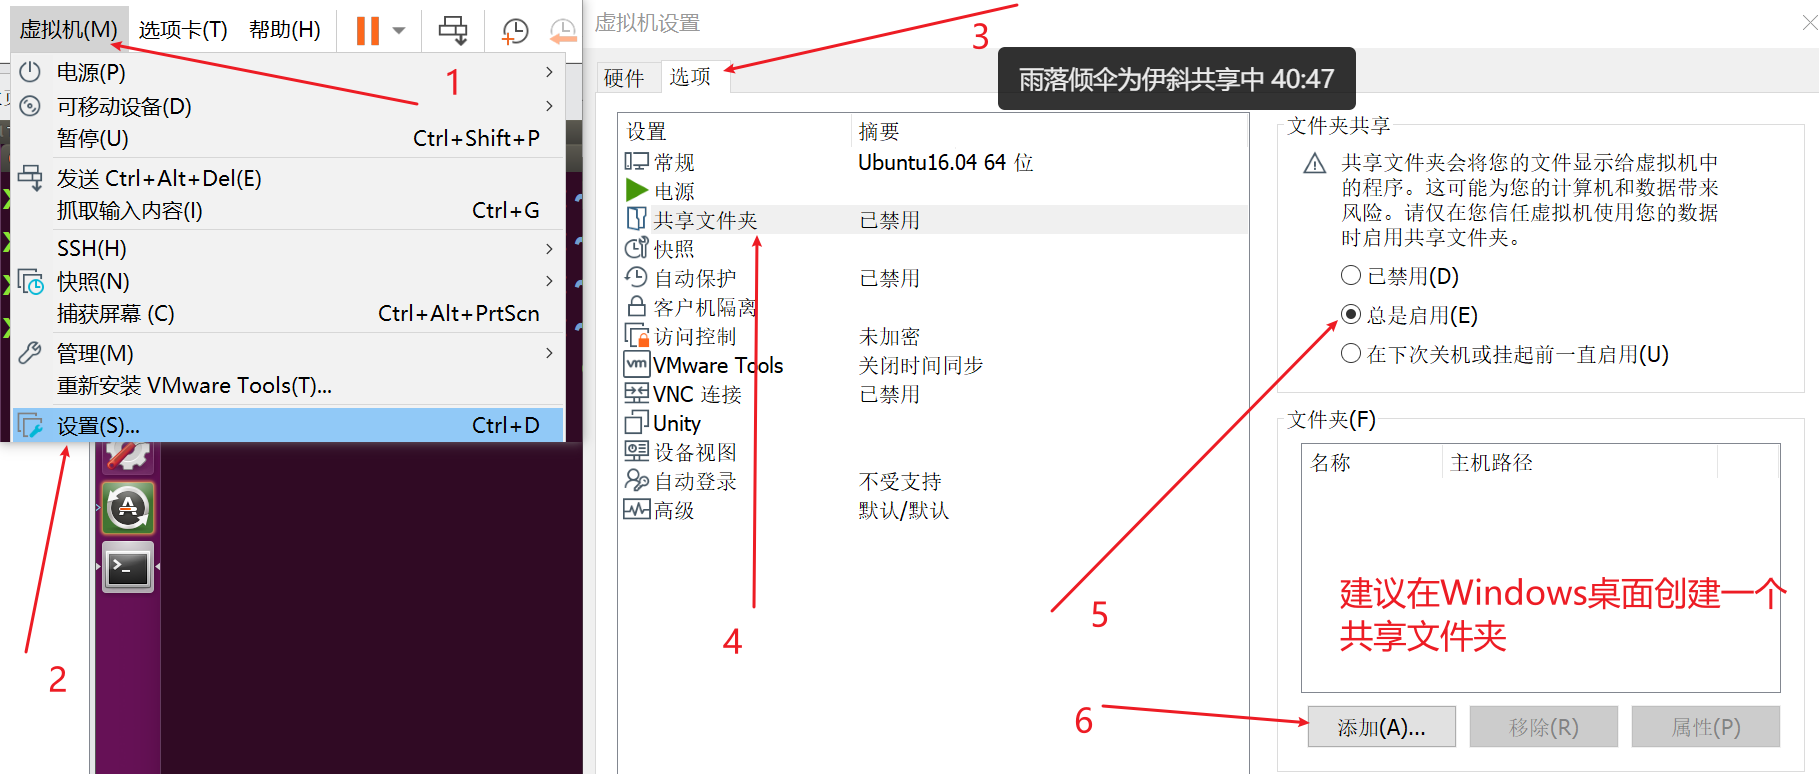
以2603文件夹,为共享文件夹
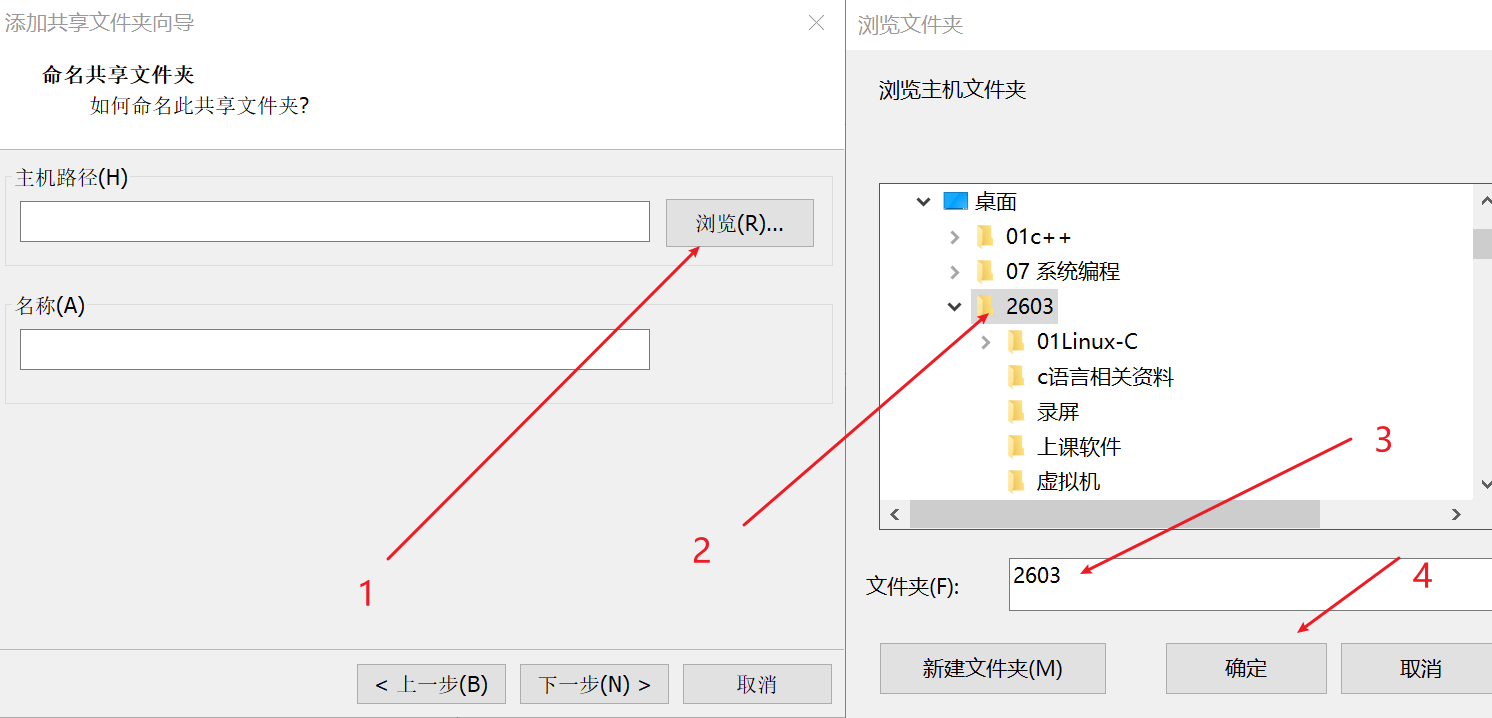
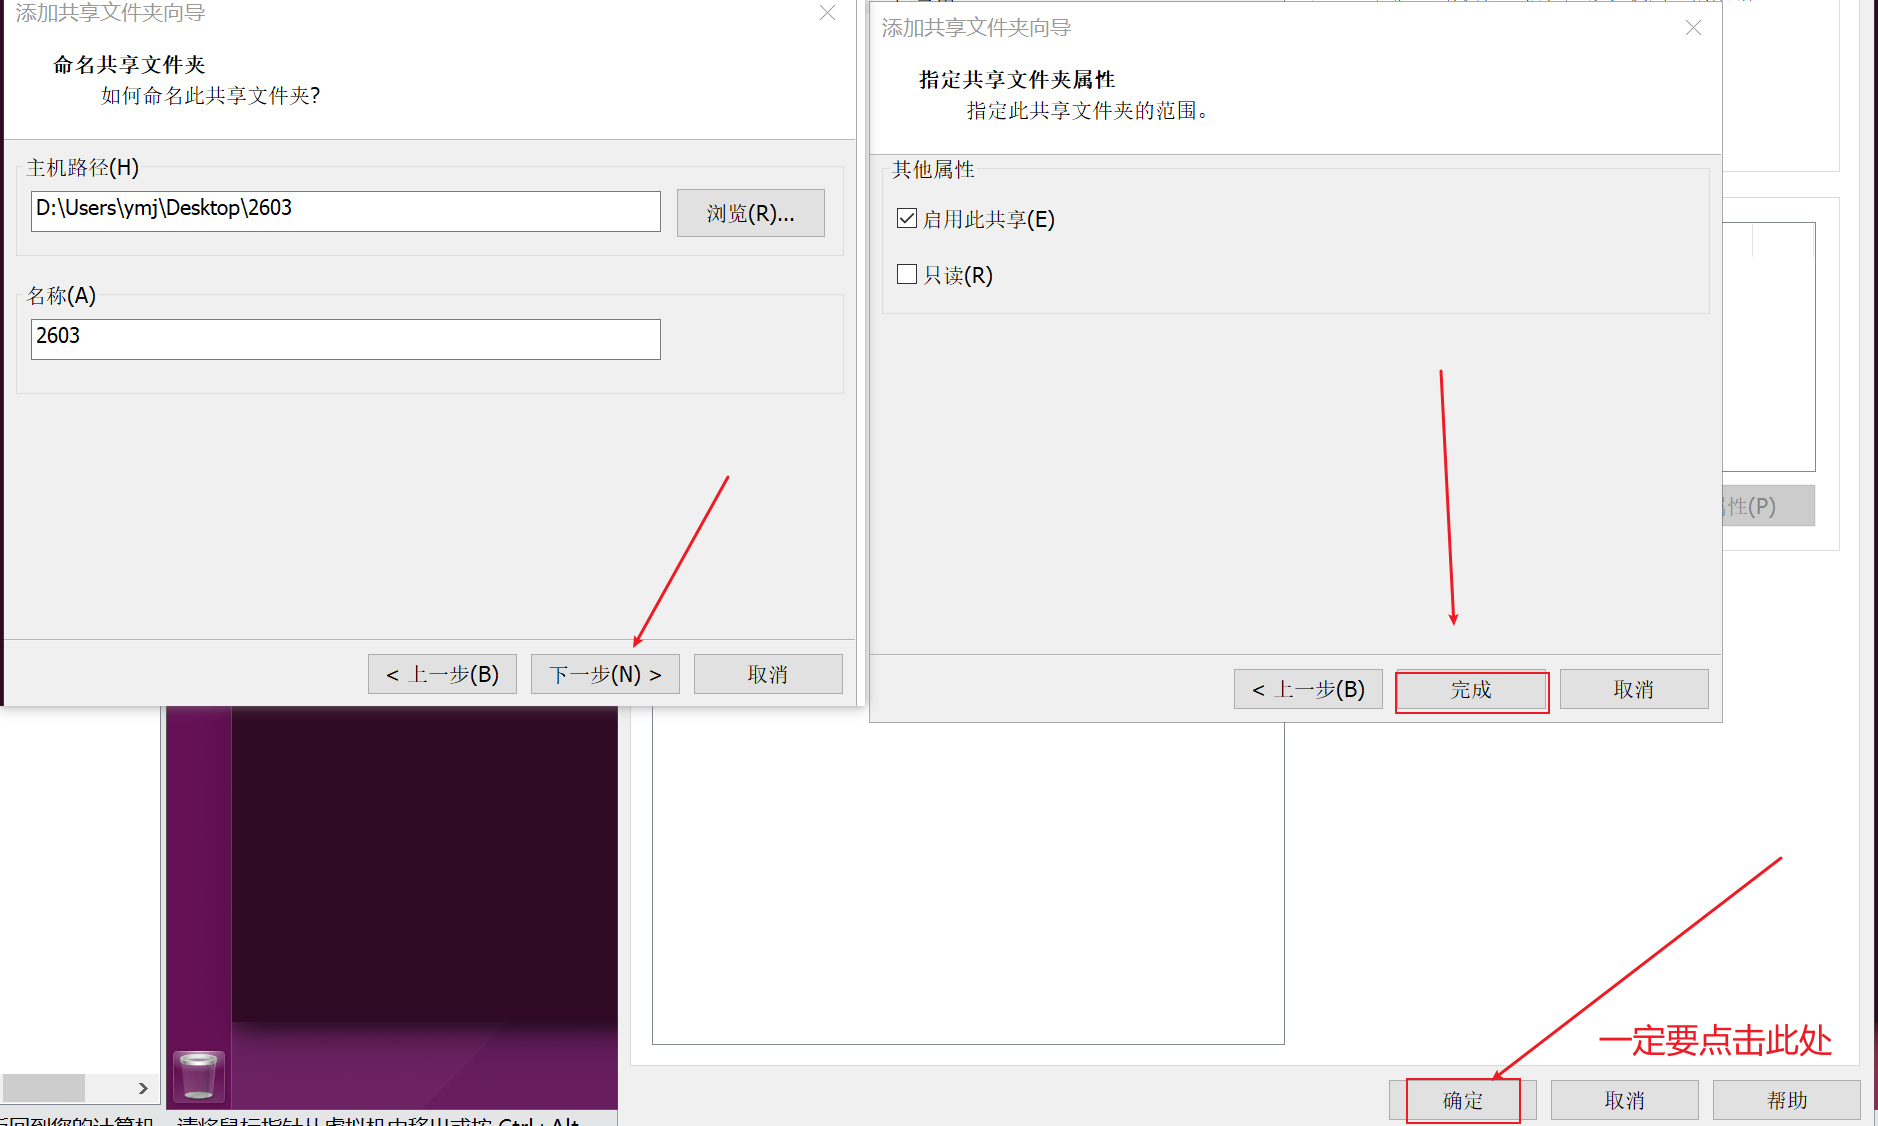
测试共享文件夹是否配置成功,
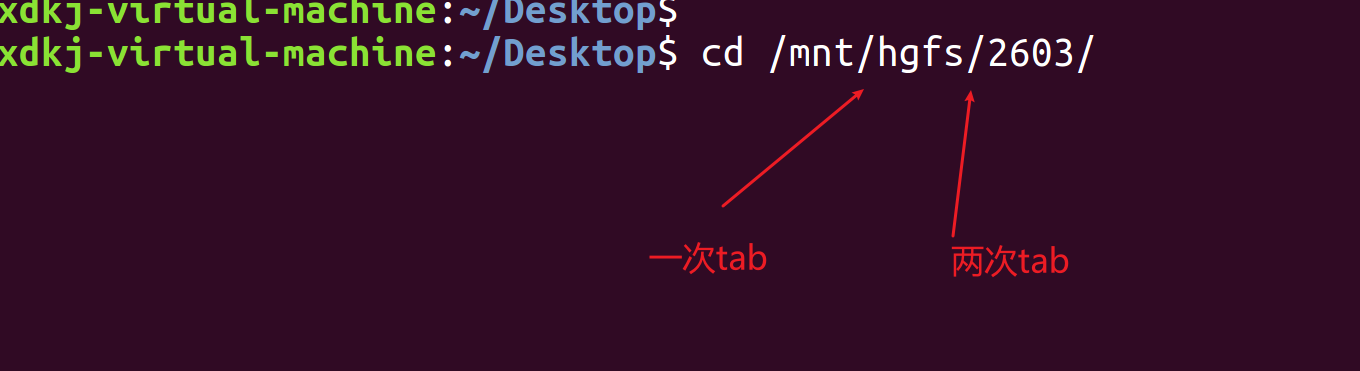
输入cd /mnt 然后不断的tab, tab键在Ubuntu是自动补齐
05-基本的shell指令
(1)ls 查看当前路径下的文件名
格式:
ls
(2)cat 查看文件,不做编辑
格式:
cat 文件名
(3)cd 切换路径
格式:
cd 路径
cd 切换到家目录
cd .. 切换到上一级目录
cd - 切换到上一次所在的目录
06-什么是嵌入式?
嵌入式即嵌入式系统,是一种对功能,功耗,成本,体积,稳定性等有严格要求的专用计算机系统,
07-嵌入式开发和PC开发的区别
表格记录
| 列1 | 列2 | | --- | --- | | 电子计算机 | 电子计算机 | 通用计算机(PC,服务器) | 专用计算机系统(嵌入式系统) | 都由软件和硬件组成 | 都由软件和硬件组成 | 硬件,软件都差不多,不同的电脑,硬件或者软件,版本,型号有差别, | 硬件和软件都是根据需求可裁剪,不同的设备,硬件或者软件可能不同 | 开发集中在上层应用(APP,数据库,wed等等)不怎么关注硬件 | 应用领域非常广泛,一个产品就需要一套系统 | 门槛低,竞争很大,人多,高薪:算法,大数据(专业,学历要求很高) | 人才缺口很大,薪资比较高
08-为什么使用Ubuntu
(1)c诞生于Unix/Linux,原生视频Linux
c语言本身就是为类Unix系统设计的,Linux是Unix同源分支,gcc是标准原生c编译器,是行业正统编译环境,是全球通用标准编译器
gcc严格遵循c89,c99, c11标准
(2)后端、嵌入式、服务器,岗位全是Linux环境
(3)统一环境,消除Windows上的差异
(4)能轻松看到c底层的逻辑,
09-LinuxC编程
(1)语言
1)编程语言(高级语言),将语言当作工具使用,c语言,c++,Java,c#,python,易语言,特点:语法,变量,控制
2)机器语言(低级语言),识别对象只有0和1,一般涉及到位移,位反等操作,特点,结构少,没有封装性,可移植性差,很难快速找到具有特定功能的代码片段,
机器语言-》a语言-》b语言-》c语言--》c++,
c语言是一门面向过程的,抽象化的通用程序设计语言,广泛应用于底层开发,c语言能够以简单的方式被编译,处理低级存储器,保留了良好的跨平台特性,
(2)程序
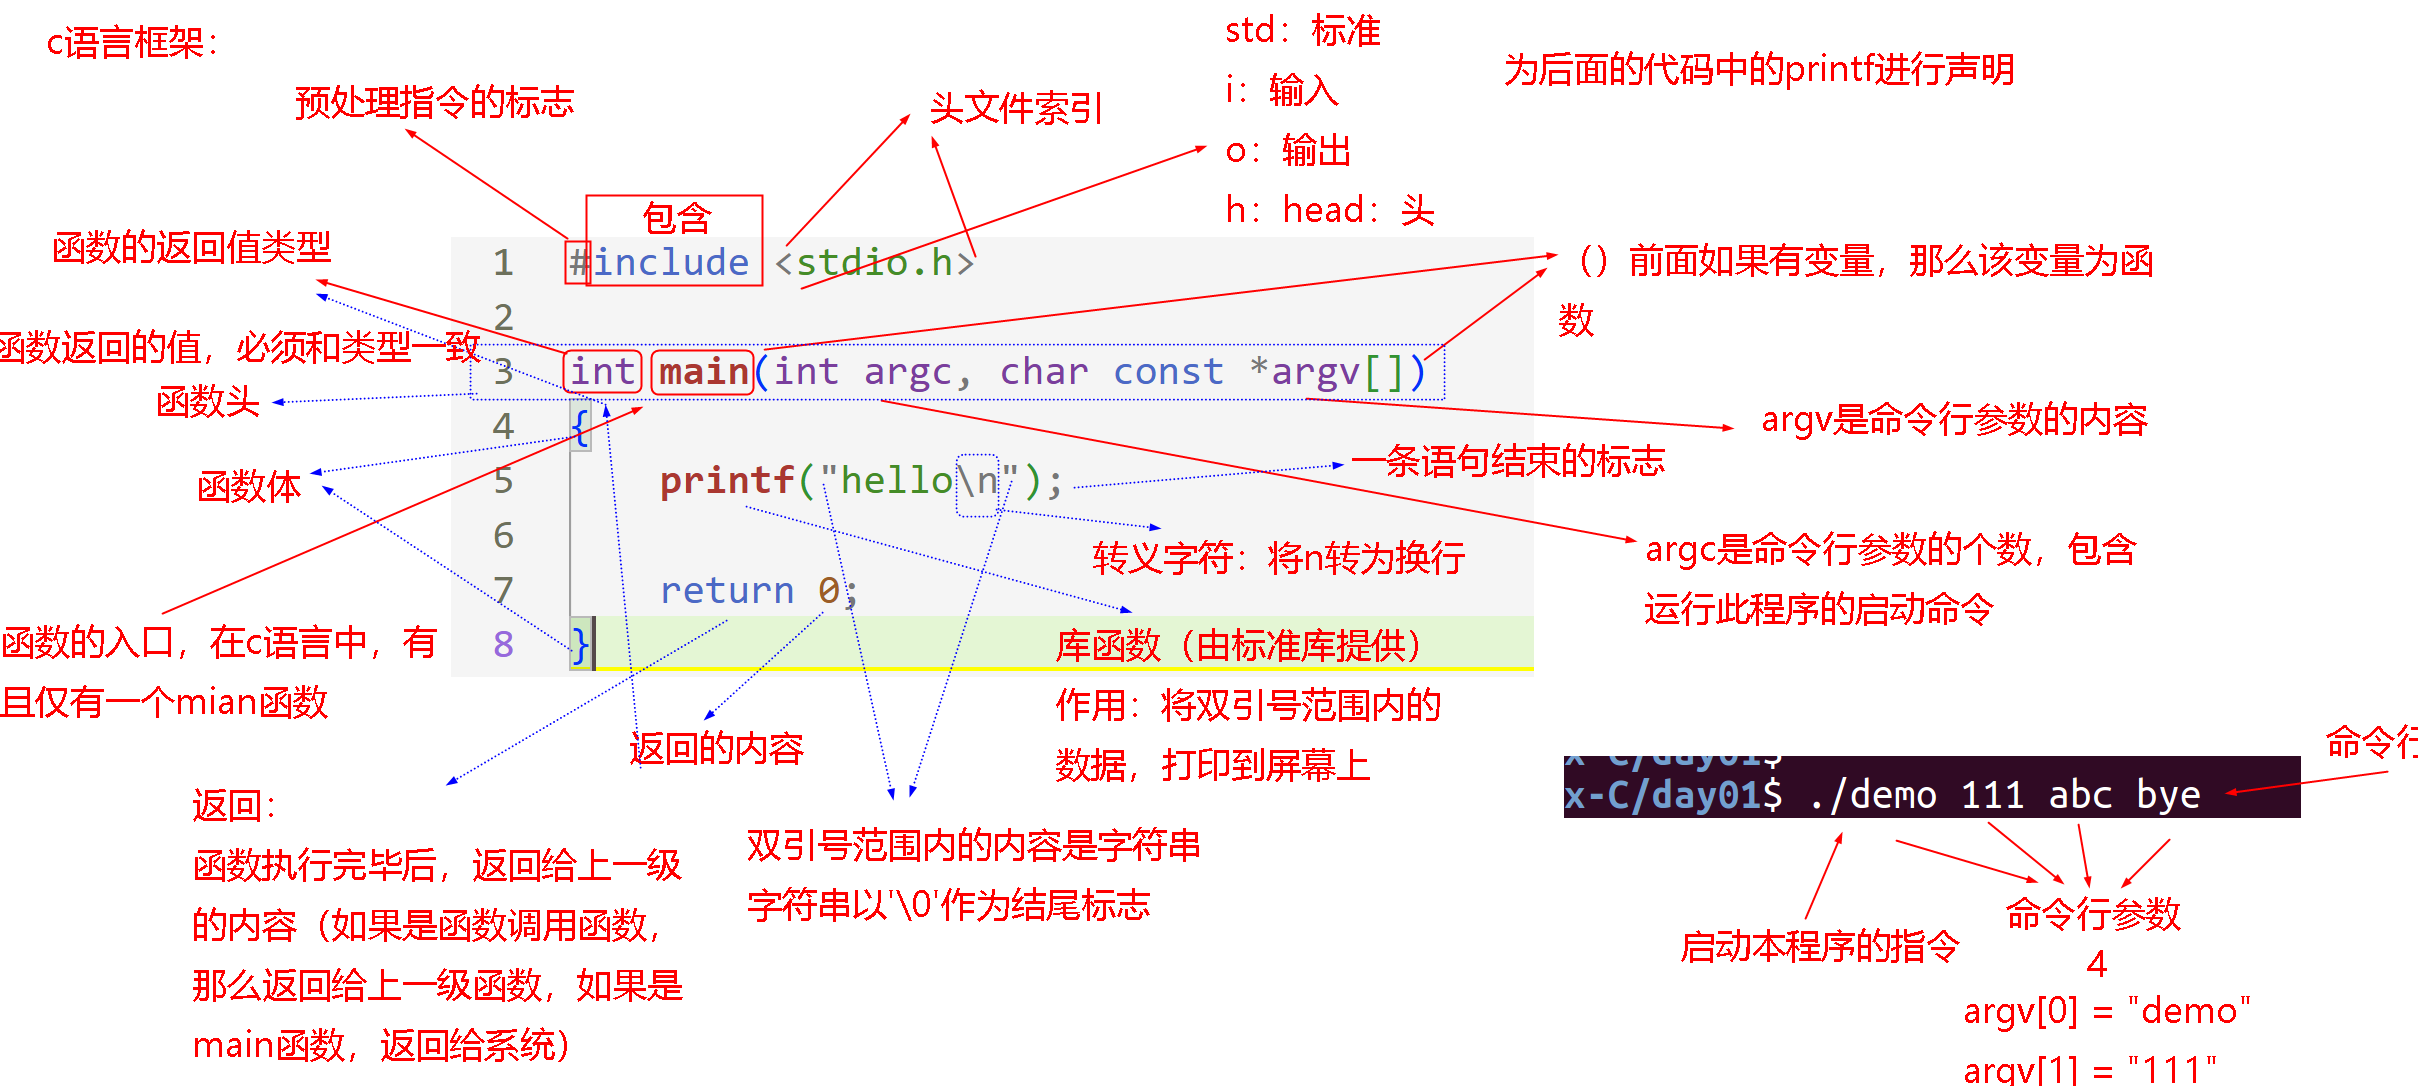
程序就是计算机可以执行的一个解决特定问题的对象(数据+算法),程序在编译的时候,一般会有一个固定的框架
总结:
1)头文件不是必须的,头文件是为了使用某个函数而做的声明,告诉编译器我们使用了哪些资源
2)c语言中的任何变量或者符号,需要在使用之前,提前声明
3)声明的概念:对源文件外定义的某个符号进行描述的过程,称为声明
4)声明的作用:经过声明的符号,编译器才能正确识别和编译,否则编译器不认识,不认可,无法判断语法错误
5)main函数是主函数,对一个工程来说,有且仅有一个main函数,它是c语言程序的入口,函数名是固定的
6)main函数返回值,默认为整型,在程序的编写过程中,如果没有返回值的需要,可以设置返回值类型为void
(3)内存
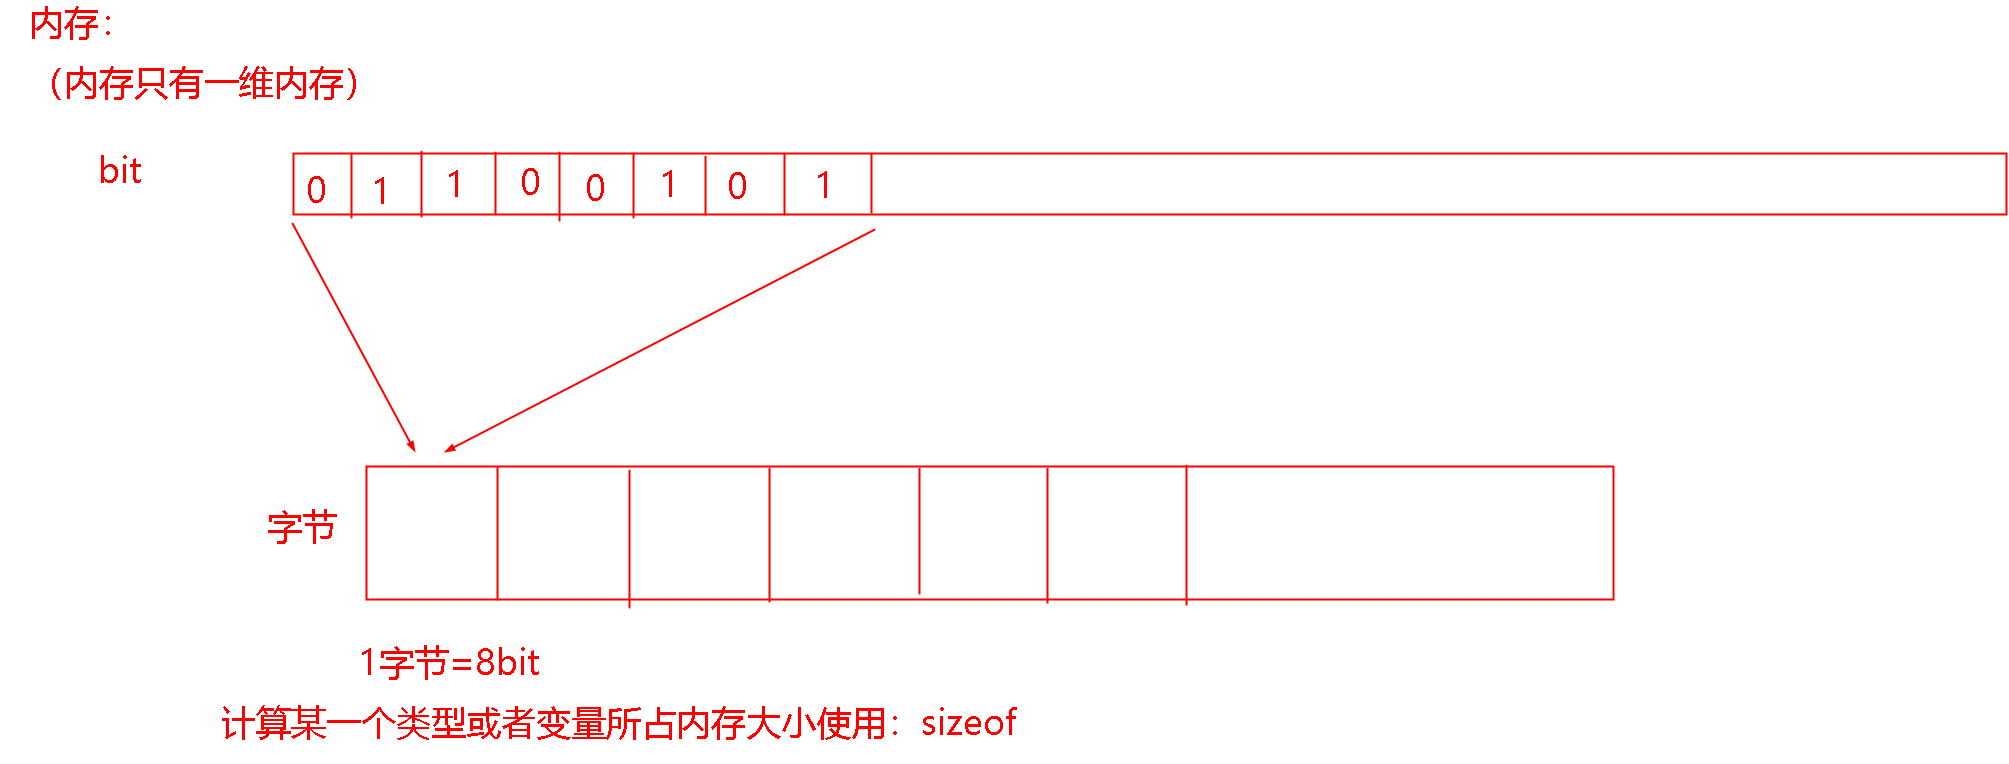
程序在执行的时候,一定是在内存中,在c语言中,程序员需要根据数据的取值范围,选择适当的数据类型,也就是根据数据的取值范围,选择合适的量程,避免内存空间的浪费,达到嵌入式系统对成本,体积的要求
比特:bit--计算机中最小的单位,一个bit只能存储0或者1 字节:byte--计算机中的基本单位,由8个bit凑成一个字节,在描述一个变量或者一个数据类型所占内存的时候,都是使用字节单位
10-数据类型
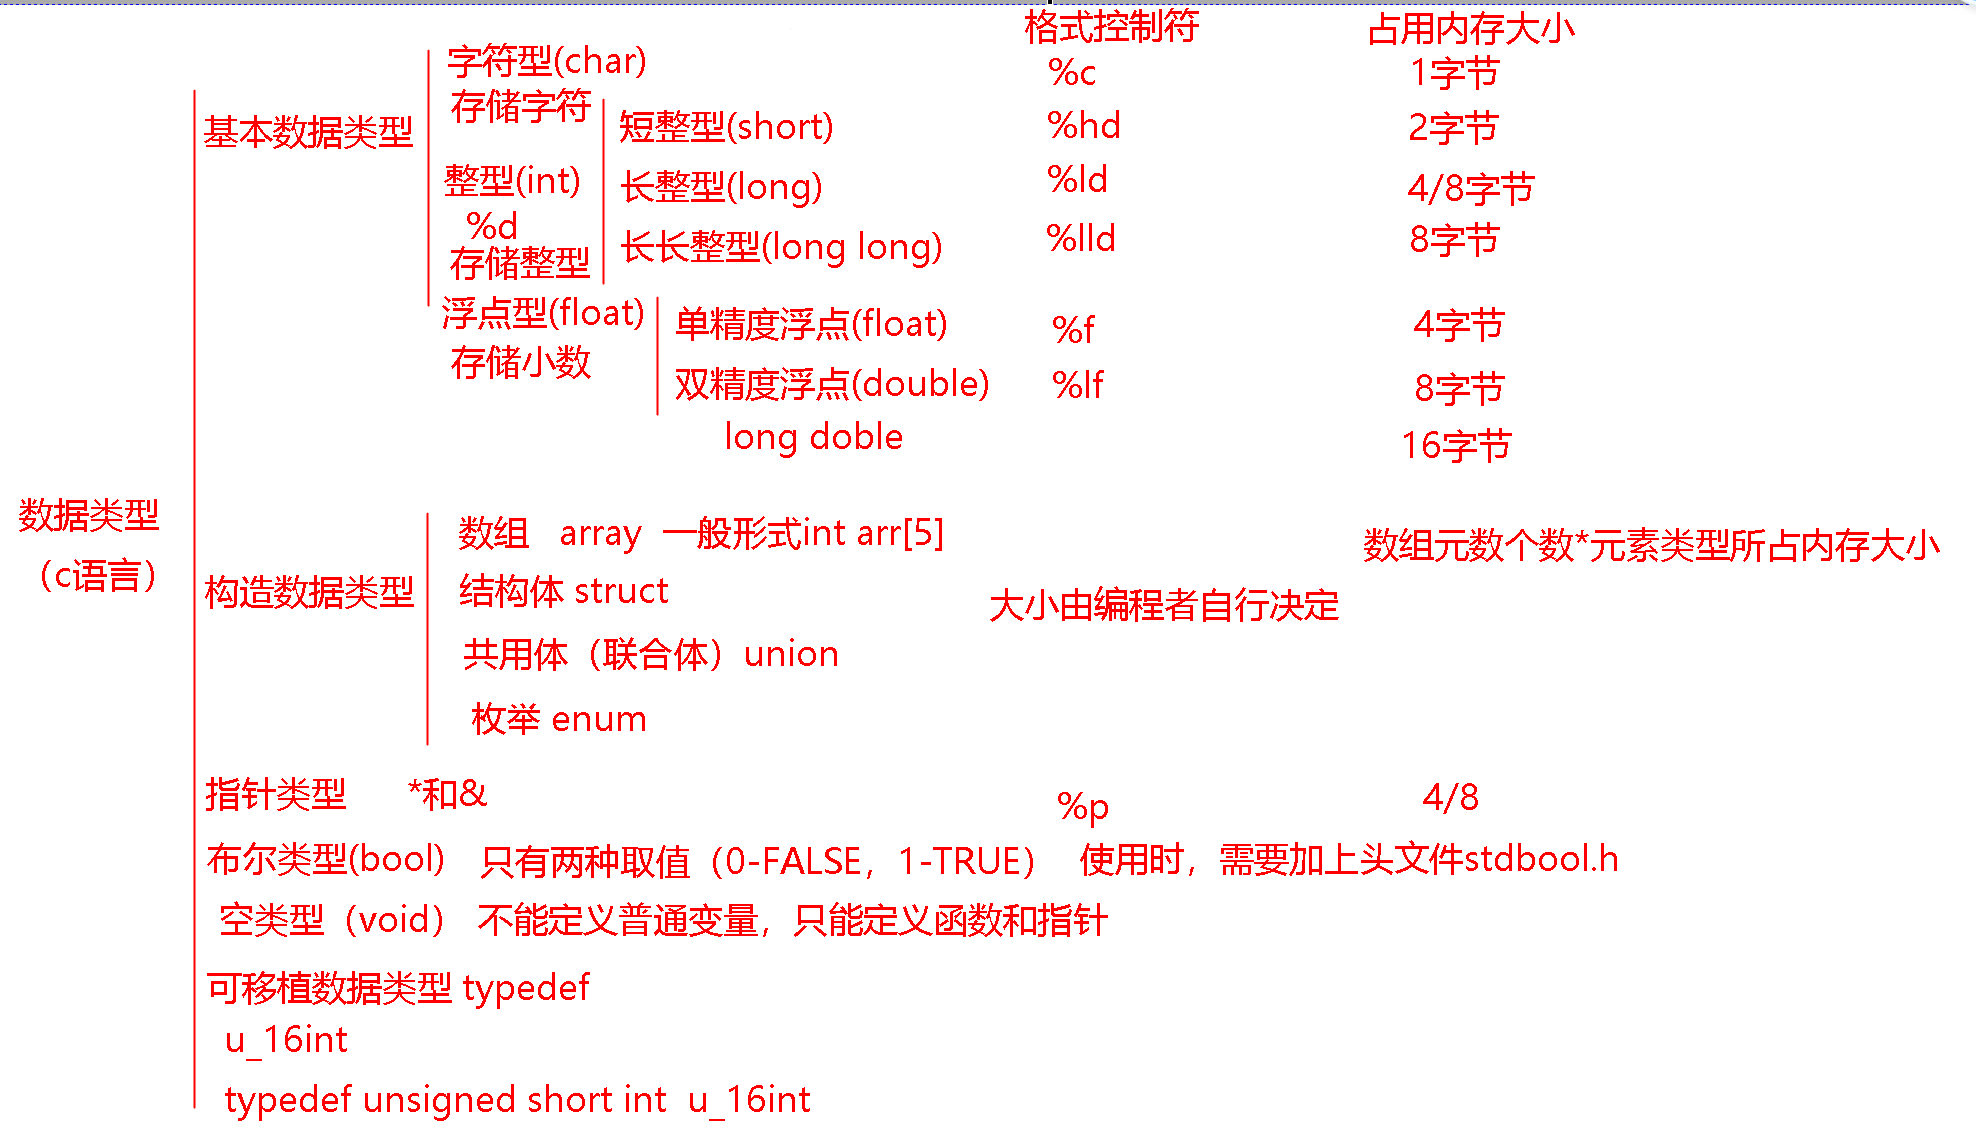
1)基本数据类型:字符型,整型,浮点型
字符型和整型在存储的时候,可以互相存储(整型可以去存储字符型,字符型也可以存储整型),但是需要注意存储范围
字符数据用单引号包含,c语言中,所有的字符参考ASCII码表使用
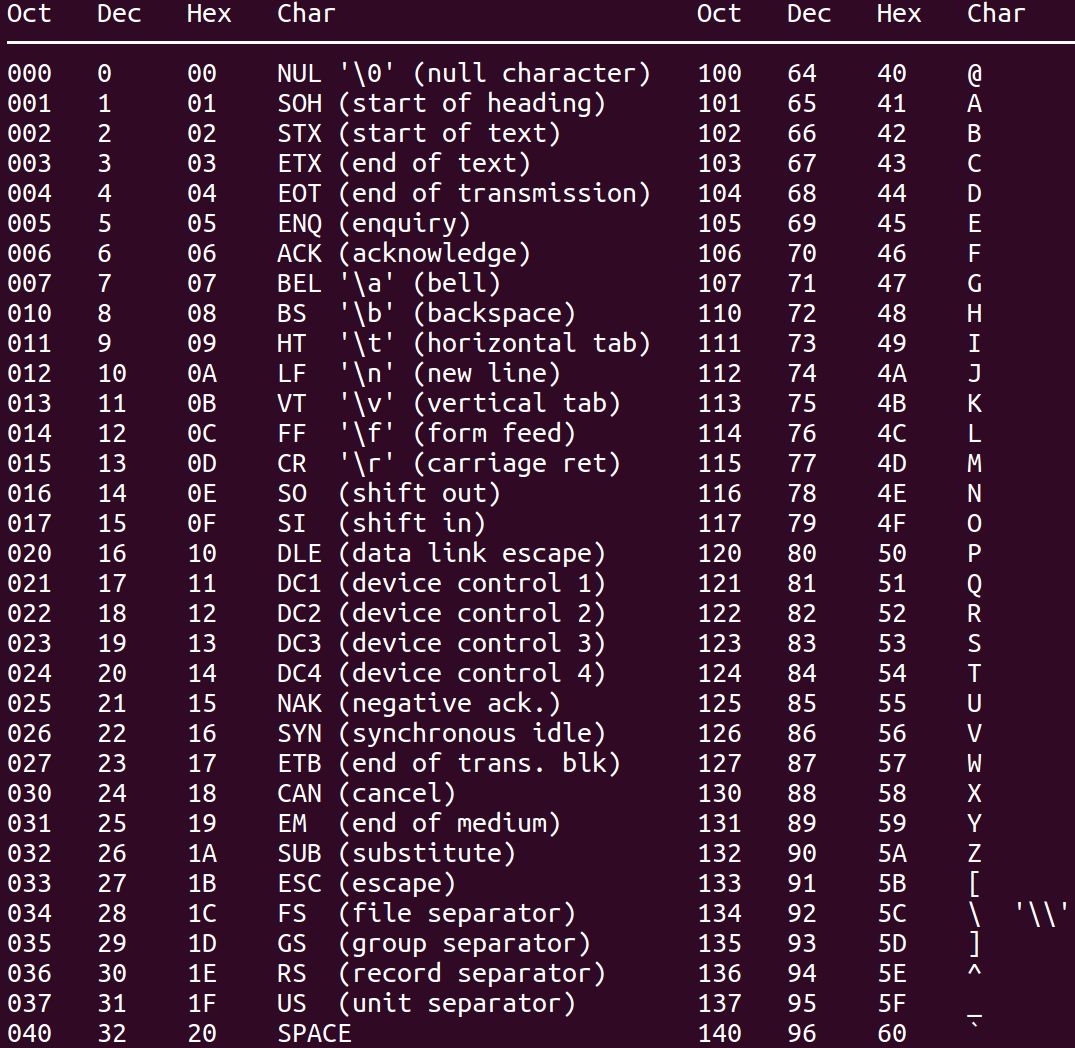
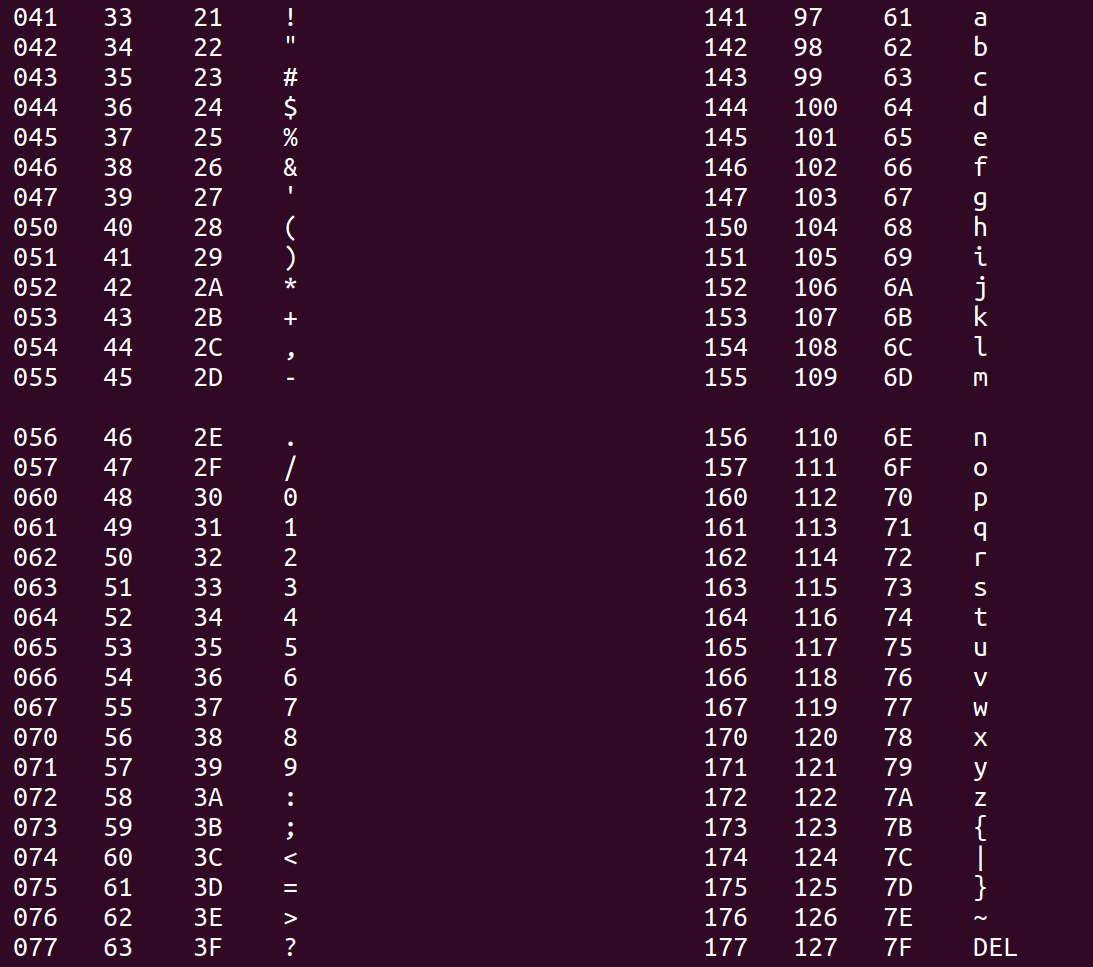
字符数据在存储的时候, 并不是直接存储字符本身,而是存储其ASCII码对应的十进制的二进制的补码
在整型存储中,数据对应的二进制的最高位是符号位,最高位为0,表示正数,如果最高位为1,表示负数
数据的源码,反码,补码规则运算
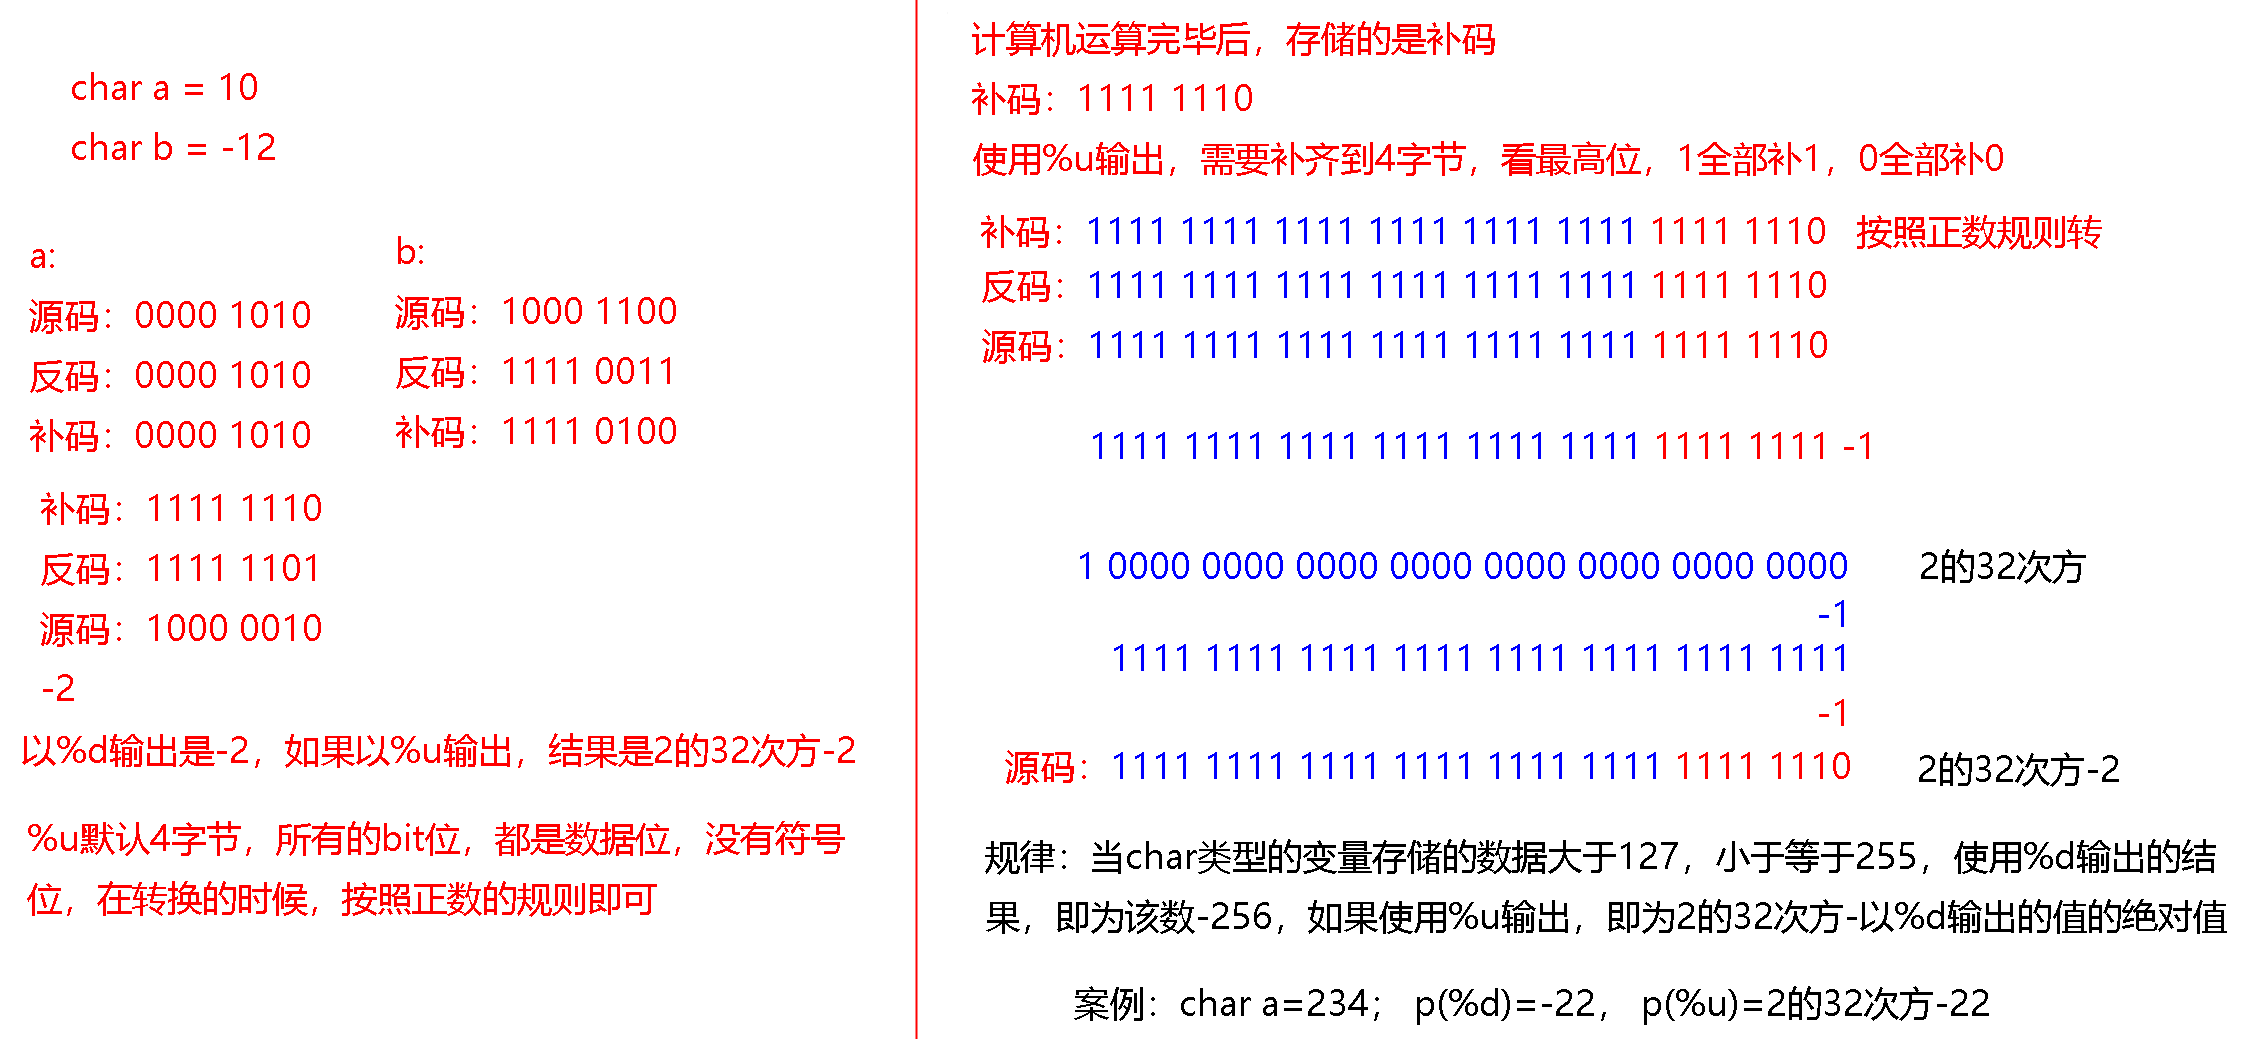
char类型的取值范围
有符号:-128~127
-128是一个特殊值,在这里只有补码,没有源码和反码
无符号:0~255
对于一个拥有xbit的数据来说,其取值范围
有符号:-2x-1~(2x-1-1)
无符号:0~2x-1
2)构造数据类型:数组、结构体、共用体(联合体)、枚举
这些数据类型的大小是不确定的,甚至可以是0,具体大小由编程者定义时决定,
3)指针类型
其大小不一定,和系统的位数相关,在64 位中,大小是8 字节,在32 位中,大小是4 字节,并且指针的大小和基类型无关,其作用是存储变量的地址
4)布尔类型
只有两种取值,不能直接使用,使用的时候,需要加上头文件stdbool.h
0-false, 1-true (false和true是宏)
定义的变量,在运算的时候,只有两种结果,要么为真(1),要么为假(0)
大小:1 字节
5)空类型
关键字:void,不能修饰普通变量,可以修饰指针和函数
6)可移植数据类型
由基本的数据类型组合而来,一般使用typedef对组合的类型进行取别名
u8, uint8_t, u16, uint16_t,等等,这些都是可移植数据类型
作用:让类型更加简单明了,能够方便程序的编写和跨平台运行
7)补充:c语言中的关键字
auto break char case const continue do double default else enum extern float for goto int if long register return short static sizeof switch struct signed typedef union unsigned void volatile while
auto:自动识别类型
register:寄存器关键字
volatile:必考的关键字,防止变量被优化
11-变量
变量实质上是内存中一个具有特定属性的存储单元,它是用来存放数据的,这个存储单元中的数据,就是变量的值,而这个值在程序运行期间可以被修改
1)变量的定义
1
2申请该数据类型对应的内存空间,并且由该变量名直接访问(助记符),
3
4变量名的组成要求:只能由数字,字母,下划线组成,并且不能以数字开头,不能和系统的关键字与函数名重名,
5
申请int类型的数据空间(4 字节),由变量a直接访问该存储空间
2)变量的赋值
左值和右值数据类型要匹配,将右值的数据赋值给左值对象(内存),区分=和==,
=表示赋值,==表示关系(值)是否相等
案例:int a=100; 表示给a所代表的空间(内存)赋值100,
1
2### 3)变量的输出printf
3
4printf是库函数,作用,将一段格式化的字符串打印到屏幕(终端)
5
6如何学习一个函数接口
7
8(1)弄清楚函数的功能
9
10(2)函数的参数,函数的返回值,函数出错的原因
11
12方法:网络搜索,查看Linux中的手册
13
14Ubuntu中,有9本手册,可以使用man man查看
15
16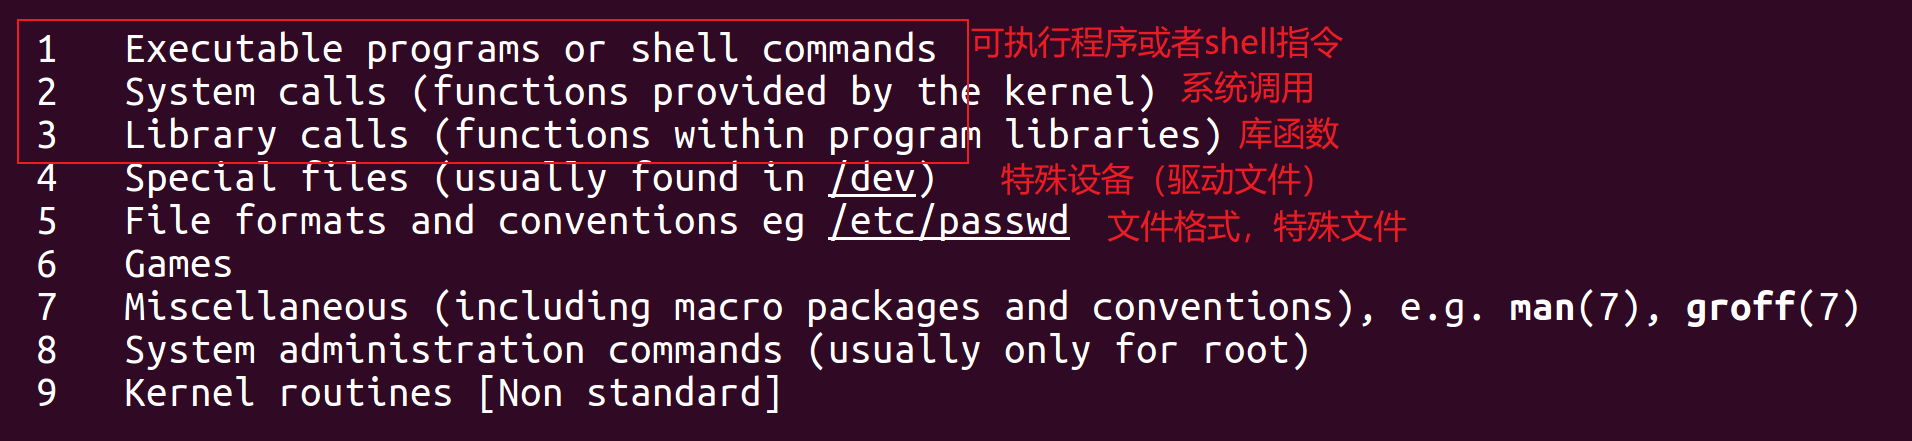
17
18一般只需要查看前3本手册
19
20案例步骤:例如查看printf函数
21
22当不知道函数是在哪一本中,使用man -f 函数,查找
23
24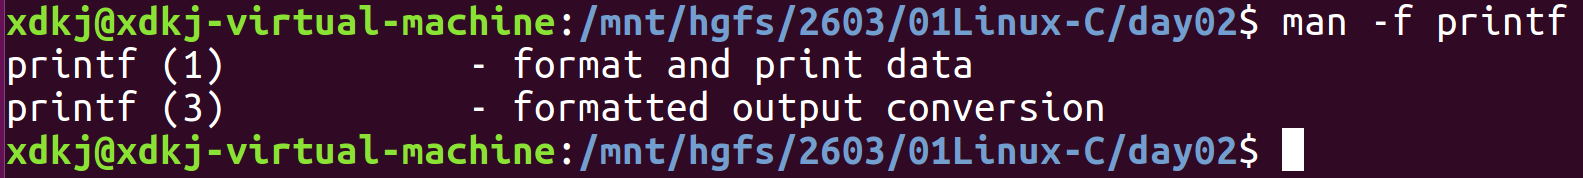
25
26通过描述,选择对应的手册编号
27
28man 编号 函数名
29
30
31
函数原型:// 将双引号范围内的数据,打印到屏幕上
1
2参数:
3
... 变参:根据实际的数据,选择需要的参数类型和参数的个数
返回值:
成功:返回的是格式化字符串中的所都格式控制符都被替换后,不包含'\0'的字符串的长度
失败:负数
注意:
1)变参的数量和格式化字符串中的格式控制符的数量应该对应,
2)格式控制符和变参的类型也需要匹配
3)变参运行的顺序从右向左
4)变量的输入scanf
1
2函数原型:从终端(键盘)获取一段格式化字符串
3
参数:
1
2...变参
3
4返回值:
5
6成功:输入成功的对象的数量
7
8失败:EOF
9
10注意:
11
121)变参中的变量,必须是一个地址类型(&变量名)
13
142)在格式化字符串中有多个格式控制符时,可以连续输入,分隔符可以是空格,换行,tab
15
163)scanf的第一个参数中,尽量不要出现格式控制符之外的内容
17
18练习:
19
20使用输入输出函数,提示一次,就输入一次,一共提示4次,然后在输入完毕后,按如下格式打印
21
22id sex name score
23
241 ‘m’ “Tom” 100.0
25
char sex; char name[10]; float score
5)补充:输入输出缓冲机制
缓冲区又称为缓存,它是内存空间的一部分,这些存储空间用来缓冲输入或者输出的数据,缓冲区根据其对应的是输入和输出,分为输入缓冲区和输出缓冲区。
缓冲区的作用:
1)减少IO设备的操作频率
2)提高计算机的运行速度
缓冲区的类型:
全缓冲:当缓冲区被填满后,才会进行实际的IO操作。比如,对磁盘文件的读写,Windows中全缓冲大小4096 字节,Linux全缓冲大小1024 字节
1)一旦填满缓冲区,就立刻将数据冲洗到文件中
2)程序正常退出时,立刻将数据冲洗到文件中
3)遇到fflush()强制冲洗时,立刻冲洗
4)关闭文件时,立刻冲洗
5)读取文件内容时,立刻冲洗
6)改变缓冲区的类型的时候,立刻冲洗
7)对普通文件而言,默认都是全缓冲
行缓冲:当在输入和输出的操作中,遇到换行符时,执行正在的IO操作,也就是立刻冲洗
比如键盘的输入数据
1)对标准输出而言,默认是行缓冲
2)行缓冲同全缓冲
3)一旦遇到‘\n’,立刻冲洗
不缓冲:不对数据进行缓冲
1)对标准出错来说,是不缓冲,
2)只要有数据,就立刻冲洗
6)补充:格式控制符
%#x,输出的时候,自带0x,表示十六进制,%#o,输出的时,自带0,表示八进制
表格记录
| 格式控制符 | 含义 | 备注 | | --- | --- | --- | | %d [int] | 有符号的十进制整数(4 字节) | 在数据没有超过ASCII码范围的时候,(0~127),对某一个数据分别以左边的格式控制符输出,实际上按照ASCII码表,输出同一行数据 | | %u [int] | 无符号十进制整数(4 字节) | 在数据没有超过ASCII码范围的时候,(0~127),对某一个数据分别以左边的格式控制符输出,实际上按照ASCII码表,输出同一行数据 | | %o [int] | 无符号八进制整数 | 在数据没有超过ASCII码范围的时候,(0~127),对某一个数据分别以左边的格式控制符输出,实际上按照ASCII码表,输出同一行数据 | | %x [int] | 无符号十六进制整数 | 在数据没有超过ASCII码范围的时候,(0~127),对某一个数据分别以左边的格式控制符输出,实际上按照ASCII码表,输出同一行数据 | | %c [char] | 字符 | 在数据没有超过ASCII码范围的时候,(0~127),对某一个数据分别以左边的格式控制符输出,实际上按照ASCII码表,输出同一行数据 | | %s | 输出字符串 | 从第一个字符开始到'\0'结束 | | %f [float] | 单精度浮点数 | 默认输出6个小数 | | %lf [double] | 双精度浮点数 | | | %e [float/double] | 科学计数法单精度浮点 | 作为科学计数表示,e前e后必有值,e后必须是整数 | | %p [x *] | 指针(带类型的地址数据) | 输出的值是十六进制格式 | | %.5s | 取字符串中的前5个字符 | | | %.5f | 取单精度浮点的小数点后5 位 | 在scanf中,不要使用此控制 | | %5d | 位宽至少为5个字符,右对齐 | 数据靠右,左侧不够补空格 | | %-5d | 位宽至少为5个字符,左对齐 | 数据靠左,右侧不够补空格 | | %hd [short] | 半个有符号数(十进制) | 表示的范围是2个字节 | | %hhd [char] | 半半个有符号数(十进制) | 表示的范围是1个字节 | | %Lf/%Le | 长双精度浮点数 | |
备注:
1)高位上的0,默认不打印
2)补充字段位宽
字段位宽指的是,字符所占的终端的列数,用户可以指定位宽,不够宽度,则剩余的用空格补齐,默认采用右对齐输出
7)补充:转义字符
表格记录
| 转义字符 | 含义 | 备注 | | --- | --- | --- | | 字符 | 含义 | 备注(对应的十进制) | | \0 | 字符串的结尾标志(空字符) | 0 | | \a | 响铃 | 7 | | \b | 退格 | 8 | | \t | 水平制表符 | 9 | | \n | 换行(LF) | 10 | | \v | 垂直制表符 | 11 | | \f | 换页 | 12 | | \r | 回车(CR) | 13 | | \\ | 表示一个\ | 92 | | \" | 表示一个“ | 34 | | \? | 表示一个问号 | 63 | | \‘ | 表示一个单引号(撇号)字符 | 39 | | \ddd | 1~3 位的八进制数,所代表的任意字符 | 三位八进制 | | \xhh | 十六进制的任意字符 | 十六进制 |
备注:小数部分在转换2进制的时候,一共只有23个bit,那么如果小数部分超过23bit,只能取到23bit,如果第24bit为1,还需要向前进一位,溢出的不再考虑,这也是浮点数为什么是近似数的原因
因为其是一个近似值,所以两个浮点数不能够直接比较是否相等,如果要比较是否相等,需要设置一个比较精度,
案例,比较flaot a,b是否相等
1
2fabs(a-b)<ESP, 则默认a等于b,
3
4补充:小数部分的二进制转10进制,
5
6二进制:0.101转十进制
7
81*2-1+1*2-3
9
10=0.5+0.125
11
12=0.625
13
14练习:将二进制数0.00101转为10进制
15
16## 12-常量
17
18常量:在程序运行期间,其值不能被改变的量
19
20整型常量:整数
21
22浮点型常量:小数
23
24字符型常量:数字、字母、符号
25
26字符串常量:由多个字符组合而来
27
28符号常量定义使用#define
29
30符号常量在使用之前,必须先定义,其一般形式
31
#define PI 3.14
1)补充const关键字:
(1)可以用来定义const常量,具有不可变性,只读,不能修改
(2)const的作用是为了给读你代码的人传递非常有用的信息的,通过给优化器一些附加信息,使之能够产生更紧凑的代码
(3)合理使用关键const可以使编译器很自然保护那些不希望被改变的参数,防止被无意的修改,可以减少bug的出现
不同内存长度的变量之间互相赋值
短的赋值给长的:从低位开始,高位补0
长的赋值给短的:从低位开始,多余的舍弃
不同类型变量之间的赋值
整型赋值给字符型: 按照ASCII码标志存放
整型赋值给浮点型: 补上小数点,补6个0
字符型赋值给整型: 按照ASCII码存放
字符型赋值给浮点型:先按照ASCII得到整型,然后按照整型赋值给浮点型
浮点型赋值给整型: 将小数点后的内容舍弃,只保留整数位
2)隐式类型转换
当一个浮点型和一个整型一起运算时,整型隐式的转换为浮点型
表格记录
13-运算符操作符与表达式
1)运算符的优先级
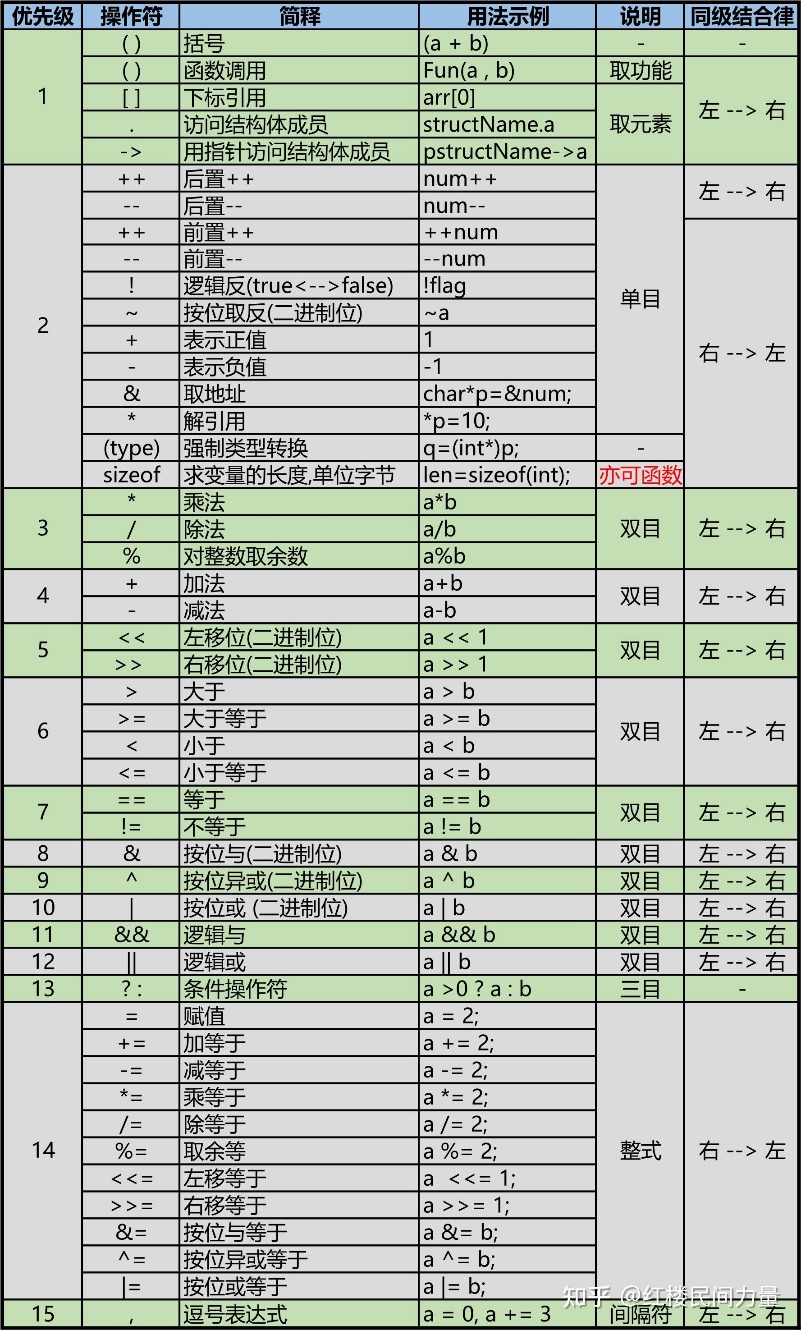
方圆括号结构体,后缀加加又减减
前缀大小取地址,正负位反非在前
强制类型做转换,算数乘商余有闲
加减位移比大小,相等不等位逻辑
与与或或算条件,赋值自反逗相连
2)单目运算符
只有一个操作数
自增和自减运算符 ++ --
1int b = a++;先使用变量a,将a的值赋值给b,然后a自加1
2int c = ++a;先让a自加1,再将a的值赋值给c
3
4对--操作一样,
5
6应用:
7
8在循环中使用较多,可以给比较多的数据做标号
9
10### 3)双目运算符
11
12算数运算的加+, 减-, 乘*, 除/,取余%,
13
14案例:5除以3=商1……余2; 得到商/, 得到余数用%
15
16注意:取余只能用于整型
17
18练习:
19
20将数字12的个位和十位拆分,然后组合为21
21
2212%10=2
23
2412/10=1
25
262*10+1=21
27
28获取一个随机数,然后随机数限制在3~10之间
29
函数原型:获取从1970年1月1日,0:0:0到现在的时间(秒)
1
2参数:
3
4time_t *tloc 用来存储时间的缓冲区
5
6返回值:
7
8成功:时间(秒)
9
10失败:(time_t)-1
11
函数原型:将秒,转换为一个字符串,包含年月日,时分秒
1
2参数:
3
4从1970年1月1日,0.0.0距离现在的秒数
5
6返回值
7
8成功:字符串(自动换行)
9
10失败:NULL
11
函数原型:将秒转换为一个结构体,该结构体中,包含了时间的各种信息
1
2参数:
3
4从1970年1月1日,0.0.0距离现在的秒数
5
6返回值:
7
8成功:结构体
9
10失败:NULL
11
12### 表格记录
13
案例:
表格记录
1// 用来存储时间(秒) time_t ret = time(&time_buf); printf("ret=%ld\n", ret); printf("time_buf=%ld\n", time_buf); char *str = ctime(&time_buf); printf("str=%s\n", str); struct tm *time_all = locAlt+ime(&time_buf); printf("年=%d\n", time_all->tm_year+1900); printf("月=%d\n", time_all->tm_mon+1); printf("天=%d\n", time_all->tm_mday); printf("时=%d\n", time_all->tm_hour); printf("分=%d\n", time_all->tm_min); printf("秒=%d\n", time_all->tm_sec); return 0; }
2
3
4随机数相关函数:
5
#define RAND_MAX 2147483647
函数原型:
1void srand(unsigned int seed); // 做随机数的种子
2
3注意:如果不设置随机数种子,默认以1作为做种
4
5练习:
6
7请输入一个4 位数,然后将个位,十位,百位,千位,拆分,然后组合成逆序的新4 位数
8
9例如:1234,拆分组合后,4321
10
11### 4)三目运算符
12
13也被称为条件运算符,是c语言中,唯一一个三目运算符,需要三个操作数
14
15格式:
16
如果条件为真,执行表达式1,否则执行表达式2
应用:高低电平设置,判断二选一
5)关系运算符
<(小于) >(大于) >=(大于等于) <=(小于等于) ==(等等与) !=(不等于)
运算结果为布尔类型,要么为真,要么为假,c语言中,非0即真
6)逻辑运算符:&& || !
逻辑与:&& ,逻辑或:|| 逻辑非:!
逻辑与:主要用来判断条件是否都成立,如果在判断的过程中,遇到有一个的条件不成立,那么立即结束判断,并且结果为假,所有的结构都为真,最后的结果才为真
逻辑或:主要用来判断条件中是否有一个为真,如果在判断过程中,有一个条件成立,则立即结束判断,并且结果为真,只有所有的条件都为假,最后的结果才为假
逻辑非:如果原本逻辑为真,逻辑非之后,逻辑为假,如果原本逻辑为假,逻辑非之后,逻辑为真
7)异或运算符
涉及到二进制bit位的运算,规则:对应bit位相同为0,不同为1
在操作中,需要将十进制转二进制,然后再进行运算
十进制与二进制转换
十转二:对十进制数,循环的除以2,获取余数,和商,然后用商除以2,不断循环,直到商为0,然后将得到的余数,逆序排列,即为对应的二进制
二转十:找到二进制中值为1的bit位,然后求2的n(对应bit后的位数)次方,然后将所有的值相加,得到十进制
八进制与二进制转换:
421算法:指的是二进制与八进制之间的转换算法,用3个二进制,表示一个八进制,高位上不够补0,本质上是利用不同位置的二进制的权重值
421案例1:二进制0110 1010转八进制
001 101 010--》152(八进制)
421案例2:八进制1732转二进制
1732--》001 111 011 010
十六进制与二进制转换:
8421算法:指的是二进制与16进制转换算法,用4个二进制表示一个16进制数,高位上不够,补0,本质上是利用不同位置的二进制的权重值
0101 0110 0011(二进制)---》0x563
0xCD56--》1100 1101 0101 0110
案例:15和63进行异或运算
a=15转二进制 0000 1111
b=63转二进制 0011 1111
第一次异或运算x = a^b=0011 0000
第二次异或运算y = x^b=0000 1111
得到结论:a^b^b == a; 该特性可以做密码
如何利用异或运算,交换两个数的值?
a=a^b; // 0011 0000
b=a^b; // 0000 1111
a=a^b; // 0011 1111
交换两个变量的值的方法:
(1)异或运算
(2)定义第三方变量,
(3)加减法
8)赋值运算符 =
左值 = 右值 左值不能是只读变量,
9)复合运算符
+=, -=, *= /= &=
1
2减少代码的执行周期,提高性能
3
4### 10)逗号运算符
5
6规则:从左往右依此运算
7
8### 11)地址运算符
9
10有两个符号:* &
11
12第一个符号:*(取值符)【解引用】 把地址还原成数据(拿到地址上的数据)
13
14第二个符号:&(取址符)取地址,获取变量的地址数据
15
16### 12)位运算符
17
18位运算符:对二进制数据进行操作,最方便,最直接的操作方法
19
20~(按位取反) &(位与) |(位或) ^(位异或) >> (右移) <<(左移)
21
22位运算是嵌入式开发中的重点和难点,因为其涉及到硬件的操作,嵌入式芯片编程(寄存器读写)
23
24按位取反:操作对应bit位,如果是0,转1,如果是1,转0 位与:对应bit位,如果都为1,则位与后为1,否则为0,
25
26位或:对应bit位,如果有一个为1,则位或后结果为1,只有全部为0,位或后才为0 位异或:对应bit位相同为0,不同为1
27
28右移:右移的单位是bit,如果右移,cpu会从最低位开始操作数据,所以位移后,超过最低位的数据,全部都会被舍弃
29
30左移:左移的单位是bit,如果左移,低位上会补0,至于高位上的数据是否舍弃,需要看内存
31
32先左移,再右移:char/short先转换为int,再位移bit数32 位及以上,不变(未定义行为),在32 位以内,左移的数据大于32 位的,高位上舍弃
33
34先右移,在左移:只要右移的数据超过了最低有效位,数据就会被舍弃,会被0替换
35
36实际应用1:对数据进行拆分和组合
37
38### 表格记录
39
// 方法一:利用求商和取模 printf("var1=%#hhx\n", var1); // 0x34 printf("var2=%#hhx\n", var2); // 0x12 // 方法二:利用存储规则和右移 unsigned char var3 = var; // 长的赋值给短的,只使用低位,0x34 unsigned char var4 = var>>8; // 右移舍弃低位,赋值规则,舍弃高位的0 printf("var3=%#hhx\n", var3); // 0x34 printf("var4=%#hhx\n", var4); // 0x12 // 组合数据:0x3412 // 方法一:+ unsigned short var5 = (var3<<8) + var4; // 0x3400 + 0x0012 printf("var5=%#hx\n", var5); // 方法二:位或 unsigned short var6 = var3<<8 | var4; // 0x3400 + 0x0012 printf("var6=%#hx\n", var6);
练习:对unsigned int var = 0x12345678;做拆分和组合,组合的数据为0x78563412,然后再次做拆分和组合,组合的数据为0x87654321
实际应用2:保留其他bit位,对其中的某一个bit位进行置0或者置1操作,或者翻转指定bit位(高低电平)
位序:对于一个字节来说,其位序:7654 3210
对第n位置1:要位或1左移n位(a=a|(1<<n))
对第n位置0:要位与1左移n位且取反(a=a&~(1<<n))
对第n位翻转:要位异或1左移n位(a=a^(1<<n))
实际应用3:利用左移和右移,代替2的幂次方运算符
结论:左移n位,该数乘以2的n次幂,右移n位,该数除以2的n次幂,对有符号不成立。
13)sizeof运算符
可以计算数据类型所占内存大小,也可以计算某一个变量所占内存大小,还可以计算某一个表达式的大小,sizeof在计算某一个表达式的大小的时候,该表达式不会运行
c语言的框架体系:
点—————数据类型
线—————运算符与表达式
面—————逻辑结构
体—————函数
14-逻辑结构
总-分-总
c语言逻辑结构组成了代码的流程,总共分为三种:
顺序结构(默认),分支结构,循环结构
1)顺序结构
从main函数开始,到return 0 结束,
功能简单,没有选择和循环,一直运行,直到结束
2)分支结构
当程序运行到某一个位置的时候,遇到关键字(if-else, switch-case)程序就会进行逻辑判断,然后根据真假选择对应分支,只能执行其中一个分支,其他的不执行
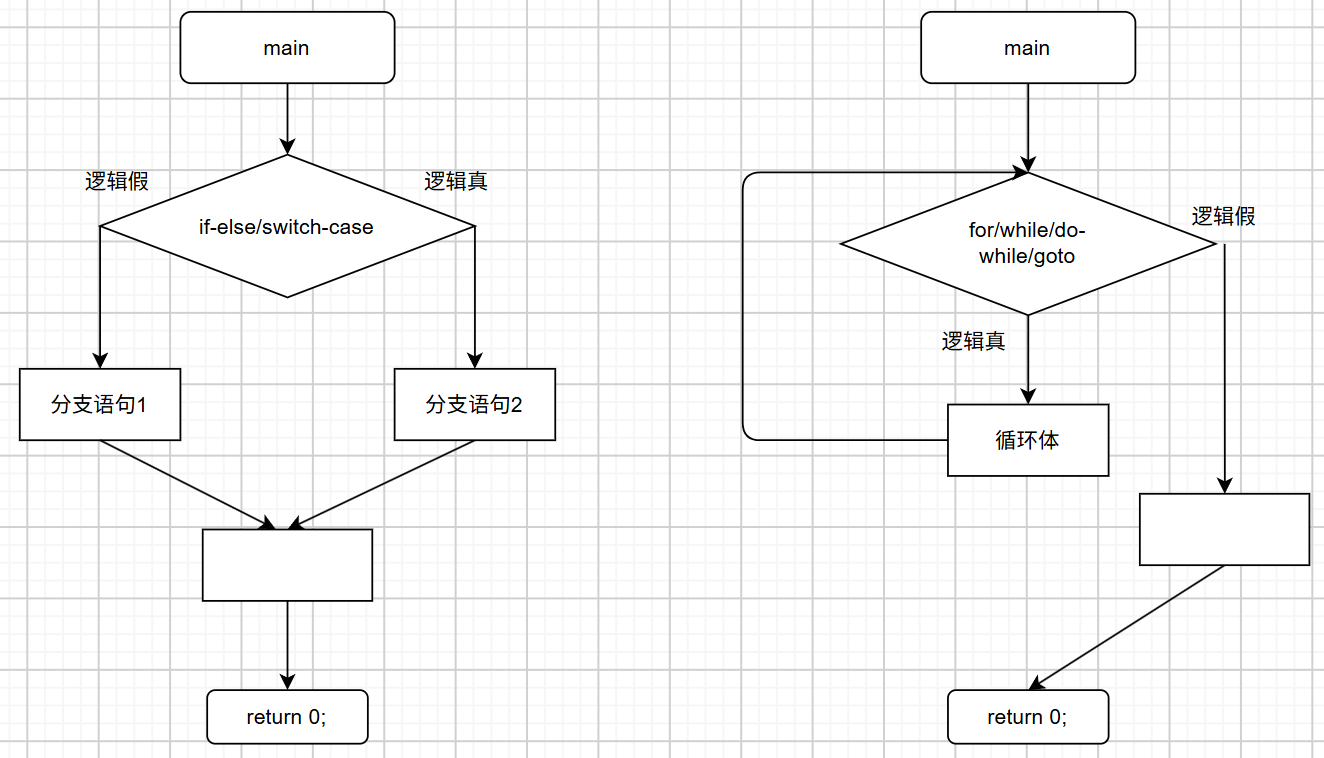
3)循环结构
当程序运行到某一个位置的时候,遇到关键字(while,do-while,for,goto)程序就会进行逻辑判断,如果逻辑为真,则执行循环体,循环体执行完毕后,继续判断逻辑表达式,如果为真,则继续执行循环体,否则退出循环,如果逻辑一直为真,则该循环是死循环
(1)控制流-单路分支if
格式:
1{
2分支语句;
3}
4
5当表达式结果为真,则执行分支语句,否则,不会执行分支语句
6
7注意:
8
91)如果没有写作用域表达符{ }, if判断只能作用于离其最近的一条语句
10
112)在分支语句中定义的变量,只做用于该分支中,分之外不能使用
12
133)在没有写作用域{ }时,分支语句中,不能定义变量
14
154)当分支内和分之外定义了同名变量,分支内对变量的修改,无法影响分之外的变量
16
17### (2)控制流-两路分支if - else
18
19格式:
20
{ 分支语句1; }
else
1分支语句2;
2}
3
4当表达式为真时,执行分支语句1,否则就执行分支语句2,
5
6注意:
7
81)分支语句1和2,只能有一个执行,不能同时执行,也不能都不执行
9
102)if和else之间,不能出现独立的语句,会导致else没有if与之对应
11
123)在一个分支中,定义的变量,不能再另一个分支中使用
13
14### (3)控制流-多路分支-if-else if
15
16格式:
17
{ 分支语句1; }
else if(表达式2)
1分支语句2;
2}
3
4。。。
5
6else if(表达式n)
7
分支语句n; }
else
1分支语句n+1;
2}
3
4注意:
5
61)从第一个表达式开始判断,只要有一个表达式为真,那么就去执行对应的分支语句,其他的分支和判断语句都不执行
7
82)else 总是会和离其最近的未匹配的if匹配,匹配后,构成多路分支
9
103)分支语句嵌套时,不要超过5层,否则会到导致程序的可读性变差
11
12练习:
13
14输入3条边,判断三角形的形状,要求判断有等边,有等腰,普通三角,锐角,钝角,
15
16### (4)控制流-入口选择分支switch-case
17
18格式:
19
{ case 常量1:// 当表达式/变量的值等于常量1,则从入口分支1开始执行 case 常量2:// 当表达式/变量的值等于常量2,则从入口分支2开始执行 case 常量3:// 当表达式/变量的值等于常量3,则从入口分支3开始执行 case 常量4:// 当表达式/变量的值等于常量4,则从入口分支4开始执行
default:// 当表达式/变量的值不等于上诉任何值,则从缺省,默认入口开始执行
1
2注意:
3
41)每一个分支结束的时候,需要有一个break;否则就会一直往下运行,
5
62)对default来说,如果其在最后的位置,可以不写break,如果在前面的位置上,需要添加break
7
83)case后面的常量不能相同,必须彼此独立,如果是一个范围,也不能重合,不能是浮点型
9
104)switch-case语句,并不是从上到下遍历,而是直接向入口跳转,非case分支,不执行
11
125)switch后的表达式或者变量必须是整型,
13
146)如果case后是一个范围:写法case 起始值 ... 终止值: 包含起始值和终止值(前面空格不能省略)
15
167)标签只能是陈述的一部分,声明不是陈述,如果在某一个分支内定义变量,需要使用{ }说明变量的作用域,一个分支中定义的变量,其他分支不可使用
17
18### (5)控制流-循环控制while
19
20格式:
21
{ 循环体; }
如果表达式为真,则执行一次循环体,循环体执行完毕后,再次执行表达式,判断,如果为真,继续执行循环体,如果为假,退出循环,
如果表达式一直为真,则为死循环
注意:在没有写{ }的时候,while只能作用到离其最近的一行
循环体执行n次,表达式执行n+1次
(6)控制流-循环控制do-while
格式:
do
1循环体;
2}while(表达式);
3
4先执行一次循环体,然后再判断表达式,如果为真,则继续执行循环体,否则就退出循环
5
6### (7)控制流-循环控制for
7
8格式:
9
{ 循环体; }
1)初值表达式最先运行,并且在一个for内,执行一次,初值表达式执行完毕后,执行逻辑表达式
2)如果逻辑表达式为真,则执行循环体,否则退出for循环
3)循环体执行一次之后,执行补充表达式,补充表达式执行一次后,执行逻辑表达式
4)所有的表达式都是独立的表达式,必须运算完毕后,才能运行下一个表达式
5)如果不写逻辑表达式,则默认逻辑永远为真,
6)for这一行的3个表达式可以不写,但是;必须存在
(8)控制流-跳转goto
goto:无条件跳转
关键字:goto
使用:goto 标签,跳转到标签所在位置
格式:
标签:// 在c语言中,把一个名字(c标识符)与某一行的地址相关联,格式为在一行的开始定义一个名字,然后加上一个冒号
xxxxx ----- 相当于循环体
goto 标签
大部分情况下,不要使用goto,一般用在无条件直接跳转的场合,有时候goto会破坏程序的逻辑,常用的环境:
1)代码调试阶段,跳过不需要重复调试的代码,代码调试完毕后,要记得删除goto相关的代码
2)在驱动的错误代码处理中
3)goto语句只能够跳转到异常处理的代码中,
硬件1初始化,
// 如果出错,关闭硬件1
硬件2初始化,
// 如果出错,关闭硬件2,关闭硬件1
硬件3初始化,
// 如果出错,关闭硬件3,关闭硬件2,关闭硬件1
优化:
硬件1初始化:
如果正常,继续,如果失败,goto error1
硬件2初始化:
如果正常,继续,如果失败,goto error2
硬件3初始化:
如果正常,继续,如果失败,goto error3
error3:
1
2error2:
3
error1:
1
2### (9)补充:break与continue
3
4break: 退出当前循环或者退出当前switch分支
5
6(1)只能用在循环和switch语句中
7
8(2)在循环中,表示退出当前循环,并且作用与包含其的最近的循环
9
10(3)在case语句中,表示结束当前入口分支,
11
12(4)在循环嵌套switch中,break只作用于包含其的最近的循环或者switch
13
14(5)在循环嵌套循环中,break只能跳出最近的一层(包含其的一层),外层的循环继续
15
16continue:结束当前循环,进入下一轮循环
17
18(1)只能用在循环中,不管嵌套有多深,只要其被包含在循环中即可
19
20(2)在while和do-while循环中,遇到continue结束当前的循环,然后跳转到判断表达式中,在for循环中,遇到continue,结束当前循环,跳转到补充表达式
21
22练习:
23
241)输入一个数,打印小于等于该数的所有素数
25
262)打印金字塔
27
28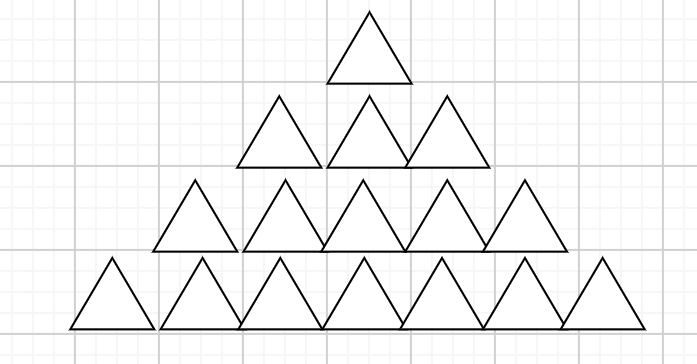
29
30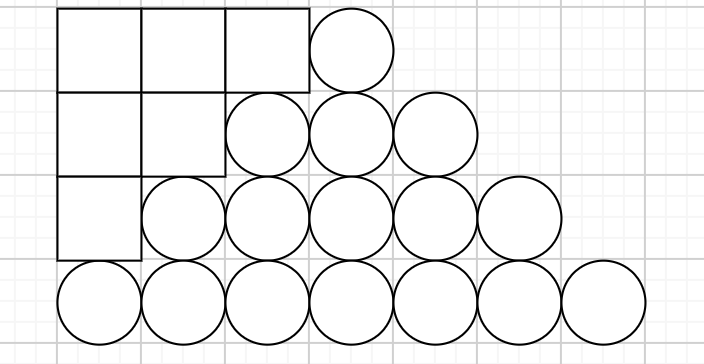
31
32对于一行的图型来说,先打印空格,然后打印符号,最后打印换行
33
34空格数量,随着行数增加,而减少,最多的空格数,等于行数-1,
35
36图形数量,随着行数增加,而增加,并且2*行数-1的数量递增关系
37
383)求两个整数的最小公倍数
39
404)打印如下字母金字塔
41
42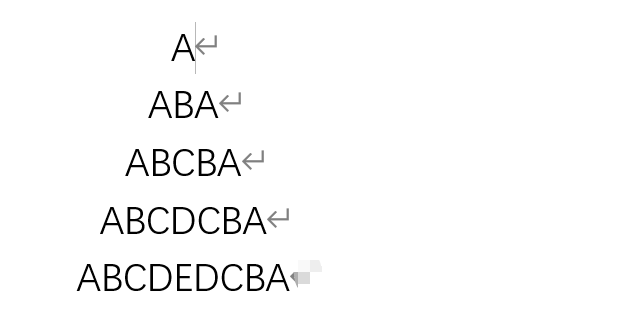
43
44z
45
46## 15-函数
47
48function:函数,功能
49
50在使用某一个函数的时候,实际上是使用某一个功能,
51
52在c语言中,会对特定功能的代码进行封装,提高代码的可读性和代码的重用率
53
54c语言中函数的分类:
55
56系统函数:库函数和系统函数,是别人已经写好的函数,也被称为预定义函数,编程者可以直接使用,不需要关注其是如何实现的
57
58自定义函数:编程者,根据实际需要,自行编写的函数
59
60主函数:main函数,它是程序的入口,当代码量特别大的时候,不要全部放在main函数
61
62子函数:自定义函数(功能函数)
63
64注意:
65
661)在操作中,调用函数会消耗栈空间,函数内部定义的变量称为局部变量,作用域只在该函数中
67
682)函数结束的时候,栈空间会自动释放,该函数所有的资源都被回收
69
703)函数调用中,被调用的函数中的return会返回给调用他的函数,A调用B,B中的return返回给A,
71
72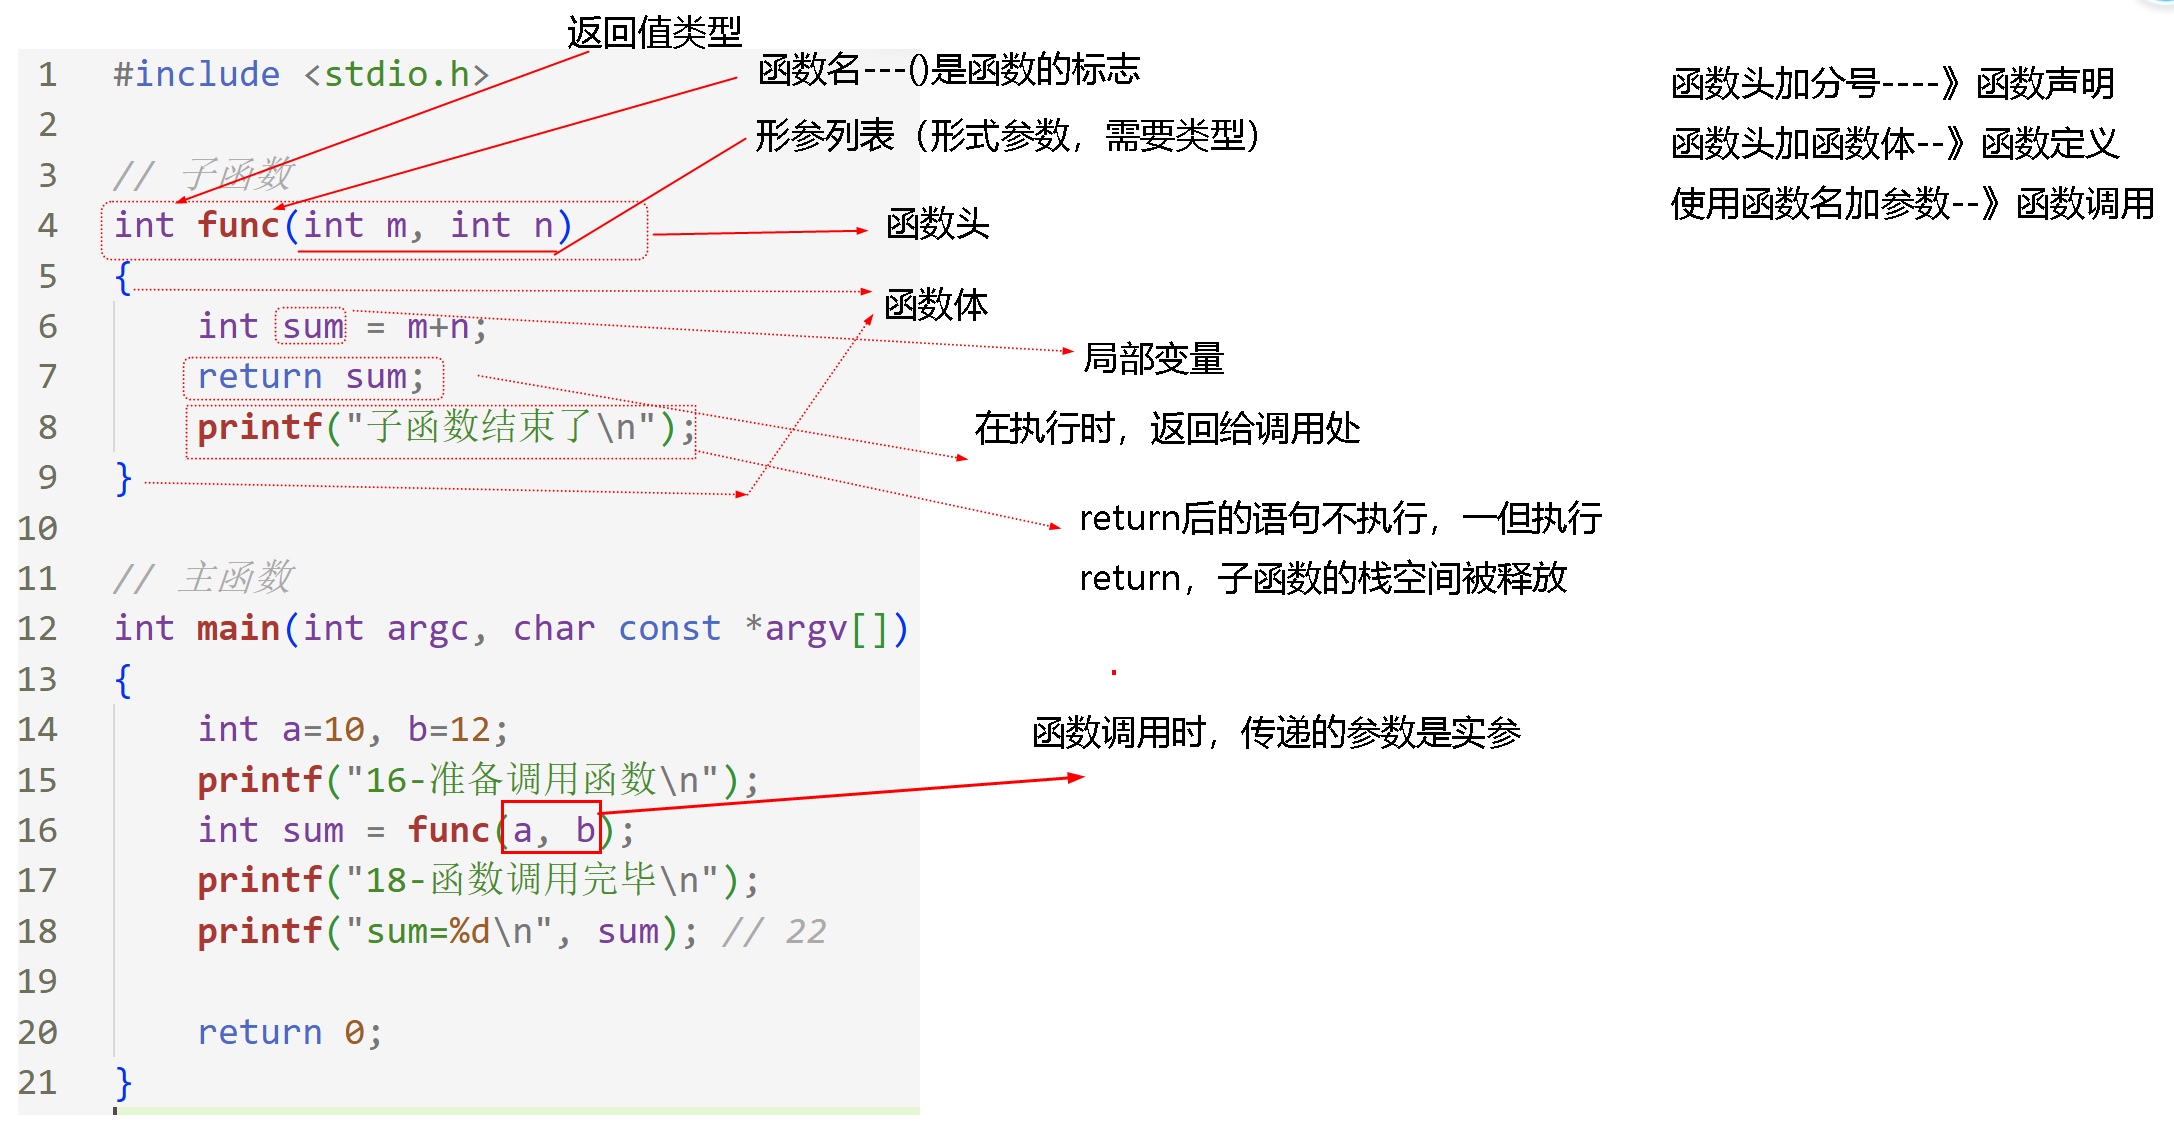
73
744)形参只对函数内部有效,形参和实参属于不同的栈空间,可以重名
75
765)如果函数的定义,在函数的调用之后,需要在函数的调用之前,添加函数的声明
77
786)如果调用函数时,其参数是函数调用,需要先将参数运行完毕,再调用本函数
79
80练习:
81
82写两个函数接口,一个func_sub(), 计算两个数的差值,另一个函数func_square(), 计算一个数的平方,要求在main函数中,输入两个整型数,然后求这个两个数的平方差,并在main函数中打印到屏幕上
83
84### 1)递归函数
85
86特点:
87
88(1)自己调用自己,
89
90(2)代码里一般来说,比较少,但是功能非常强大,
91
92适用场景:
93
94(1)有结束条件,
95
96(2)算式的前一式和后一式存在等式关系(逻辑关系)
97
98案例:求6的阶乘
99
1006!= 6*5!---》 func(6) = 6* func(5)--》func(n) = n*func(n-1)
101
102结束条件,n==1
103
104要求,
105
1061)利用递归的方法,求从1累加到n,
107
1082)利用递归的方法,求字符串的字符个数
109
110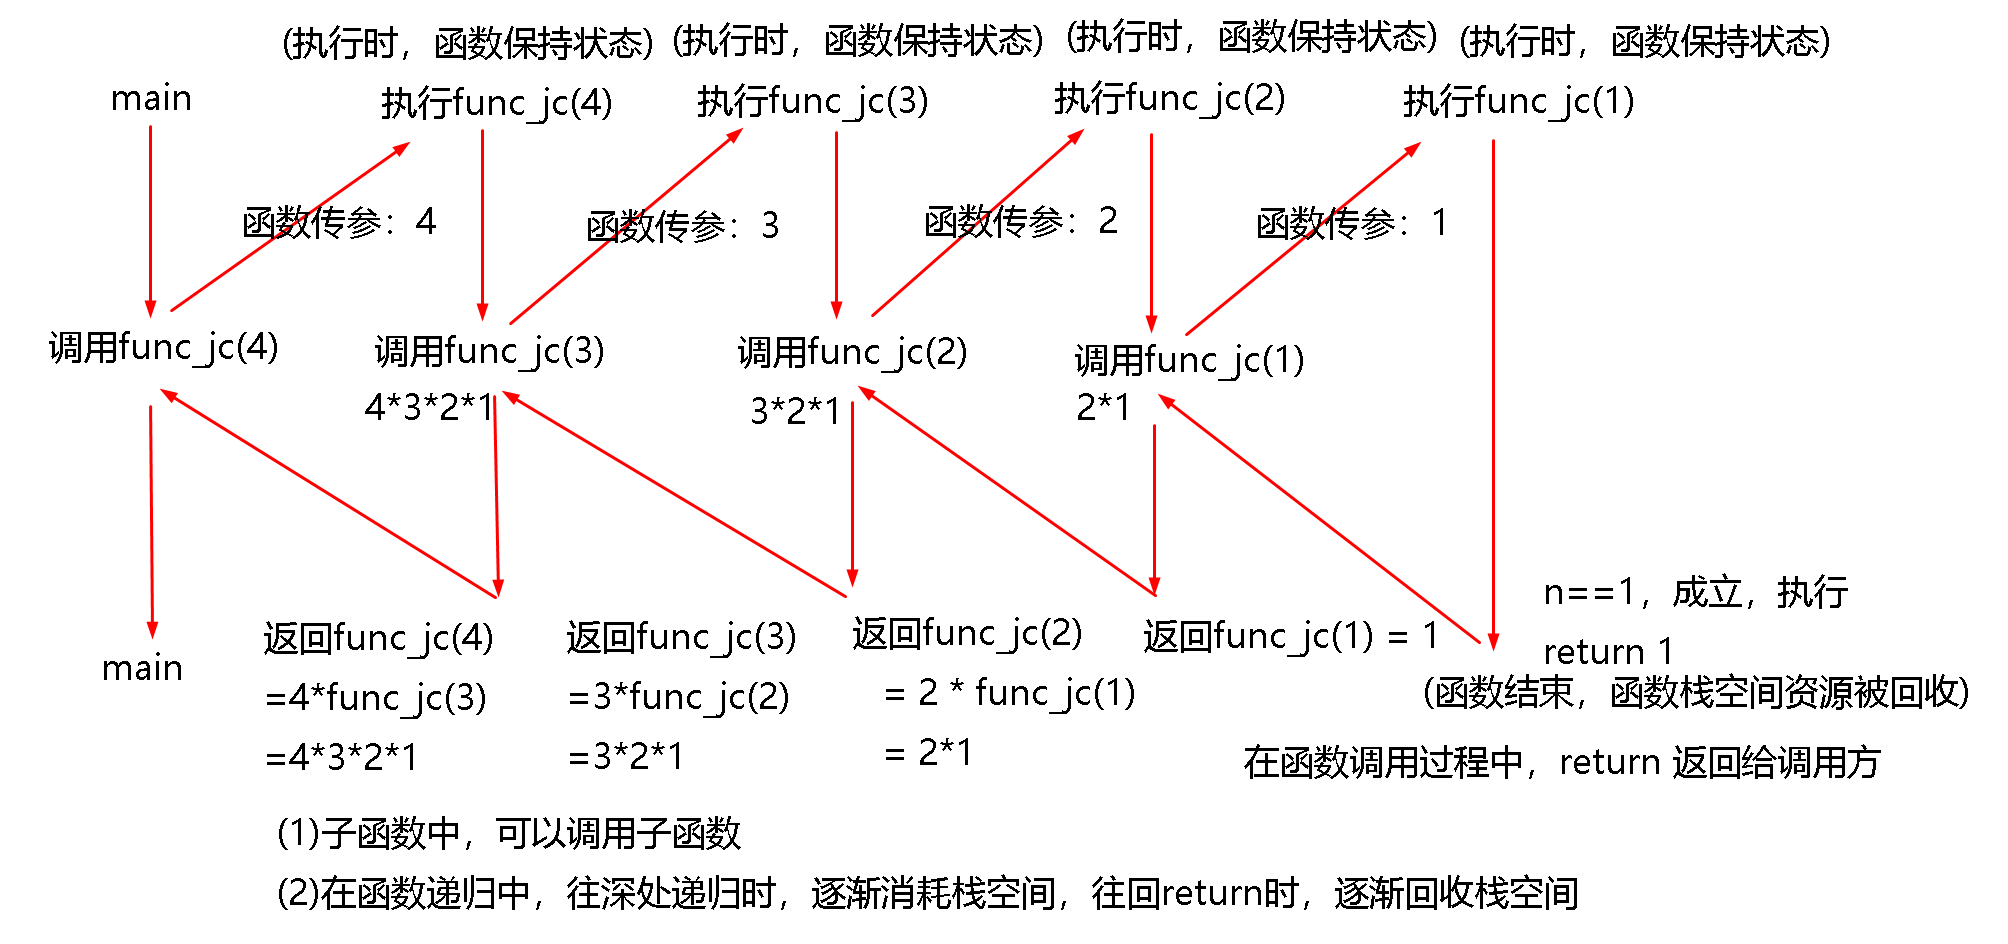
111
112练习:求斐波拉契数量的第n项
113
1141,1,2,3,5,8,13,21,34,55,…… 数列
115
1161,2,3,4,5,6,7, 8, 9, 10,…… 第n项
117
118## 16-数组
119
120窍门:把内存操作的图形,画出来,然后进行分析
121
122### 1)数组的含义:
123
124一整块连续的内存,存储着具体长度的相同类型数据。数组三要素(连续内存,具体长度,相同类型)
125
126数组是由相同数据类型的多个元素所组成的一种复合数据类型
127
128### 2)数组的理解:
129
案例:int arr[5] = {1,3,5,7,9}; [ ] 是数组的标志
1
2arr:数组名(数组名就是数组首元素的地址)
3
4[5] : 数组的元素个数(5个元素)
5
int arr[5]的含义:向系统申请了一块连续的内存,该内存大小5个int,存储5个整型数据
内存上的int arr[5], 5个int紧密连续的排列在一起
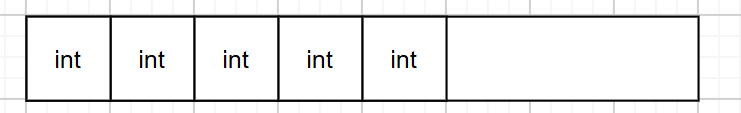
方便管理相同的多个数据
表格记录
1
2
3### 3)数组的初始化
4
5### (1)定义并初始化
6
7a)在定义并初始化时,如果只初始化部分数据,那么其他元素自动置0,元素之间使用逗号隔开,数据类型要匹配
8
9b)在定义并初始化的时候,如果赋值数据小于元素的个数,那么按照顺序赋值,并且初始值不能超过元素的个数
10
11c)清空数组的方式:一:定义时,初始化为0,二:memset()
12
函数原型:
1
2参数:
3
int c, // 要填入的内容,一般来说写0 size_t n // 要清空拿到内存的大小
返回值:
返回指向数组的指针
(2)指定元素初始化
练习:
1.定义一个拥有10个int的数组,将前5个初始化为666,后5个初始化888
2.将数组所有的元素进行打印
3.将最后一个元素修改为123
4.再打印所有的元素
a)使用[x] 对需要指定的元素定位,x为下标,操作在初始化的{ }中
b)在定义时需要初始化某一个范围,使用[x ... y] = 值,注意x后的空格不能省略
表格记录
1
2
3### (3)先定义,后初始化
4
5a)只能通过下标对数组的单个元素进行赋值,并且如果只赋值部分元素,其他元素不会自动置0
6
7### 表格记录
8
// 定义 // arr[10] = {1,2,3,4,5,6,7,8,9,0}; // 错误写法(arr[10]访问越界,表示第11个元素) // 在定义后,使用数组名加方括号加下标,只表示对下标为x的元素访问 // arr = {1,2,3,4,5,6,7,8,9,0};// 错误写法 // 单个的arr表示的是数组名,是数组首元素地址,一个地址不能被赋值 // arr[0 ... 9] = {1,2,3,4,5,6,7,8,9,0};// 错误写法 // [x ... y] 只能用于数据初始化的时候指定元素或者范围 // 可以操作的方法 for(int i=0; i<10; i++) { arr[i] = i+1; } // 单个赋值 arr[0] = 1; arr[1] = 2; ...
4)数组传参
数组在传参时,形参获取的不是整个数组,而是数组的基本元素类型的指针的大小,结果要么是4 字节,要么是8 字节
为什么数组在传参时,退化为指针,因为数组名是数组首元素的地址,所以是一个地址类型(指针类型),形参类型和实参类型匹配,所以形参也是指针类型
表格记录
1// 定义并初始化 show_array(arr1);
2// 实参的类型是:arr1是数组名,是数组首元素的地址
3// 数组首元素是arr[1],1,int类型,地址类型就是int *,即实参类型为int *
4// void show_array(int len, int arr[5])
5// 数组原型
6// void show_array( int len, int arr[len])
7// 变长数组
8// void show_array( int len, int arr[])
9// 柔性数组 void show_array( int len, int *arr)
10// 指针类型
11
12
13### 5)柔性数组和变长数组
14
15总结:
16
17柔性数组必须初始化,即使长度为0也要初始化,初始化的数据长度和类型的乘积,决定了柔性数组的长度
18
19变长数组不能初始化,其占用内存,为在定义数组的时候,数组元素类型*变量大小,一但申请内存后,数组的内存大小就固定,后续无法更改
20
21### 6)字符数组
22
23字符数组,数组元素是char(字符型)的数组
24
char c2[ ] = {"china"}; char c3[10] = {'c', 'h', 'i', 'n', 'a'}; char c4[10]; c4[0] = 'c'; c4[1]='h'; c4[2]='i'; c4[3]='n; c4[4]='a';
注意:
c1中的字符,不能构成字符串,缺少'\0'
c2中的字符,本身就是字符串格式,双引号范围的内容是字符串,包含'\0'
c3中的字符,可以构成字符串,只初始化部分元素,剩余的元素自动置0,对应'\0',有字符和'\0' 构成字符串
c4,先定义后初始化,剩余的元素位置,不一定是'\0',所以不一定能够构成字符串
对于字符数组来说,要先判断其存储的字符能否构成字符串,如果可以,则字符串相关的函数接口都可以使用,否则就只能用下标操作
7)二维数组
二维数组,一般可以理解为行列式,先行后列
1
2第一行:1,3,5, 第二行 2,4,6
3
4### 表格记录
5
6| 第一列 | 第二列 | 第三列
7| 第一行 | 1 | 3 | 5
8| 第二行 | 2 | 4 | 6
9
10
11### (1)二维数组初始化
12
13a)分行给二维数组赋初值
14
// 在内层中,一个{ },表示一行数据
b)将所有的数据写在一个花括号内,按数组的排列顺序对各元素赋初值
c)对部分元素赋初值,其余的元素自动置0
d)如果对全部元素赋初值,则定义数组时,可以对第一维的长度省略,但第二维的长度不能省略
1// 可以看到每一行有4列,按照初始化的数据,至少3行,如果是3行,还需要补2个0
2
3### (2)二维数组的传参
4
5练习:在上一个练习的基础上,把打印数组元素的循环,封装在show_array函数中,要求能够打印同元素类型的任意行,任意列的数组
6
7### 表格记录
8
// 数组原型 // void show_array(int len1, int len2, int arr[][10]) // 柔性数组 // void show_array(int len1, int len2, int arr[][len2]) // 变长数组 void show_array(int len1, int len2, int (*arr)[10]) // 指针类型
思考题:
a)int (*a)[10] 与int *a[10]的区别是什么?
第一个是数组指针,第二个指针数组,一个是指针(指针指向数组),一个数组(数组存放指针)
b)为什么柔性数组的第二个(列)的大小不能删除
因为在c语言中,二维数组并不是独立的一个类型,在操作中,只有一维数组,因为内存只有一维,说二维只是方便人们理解,实际上,二维数组本质上,也是一维数组
(3)二维数组的分析
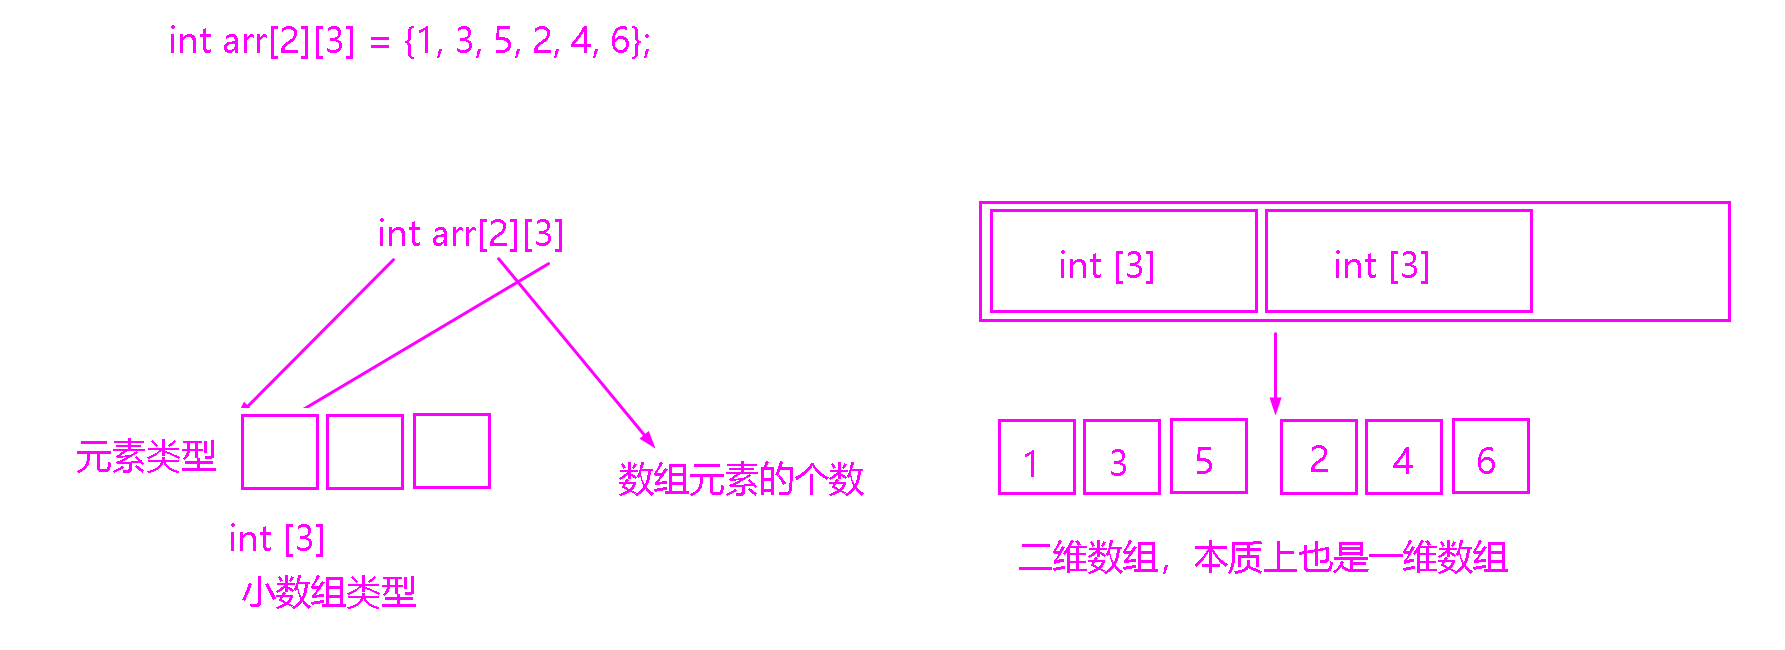
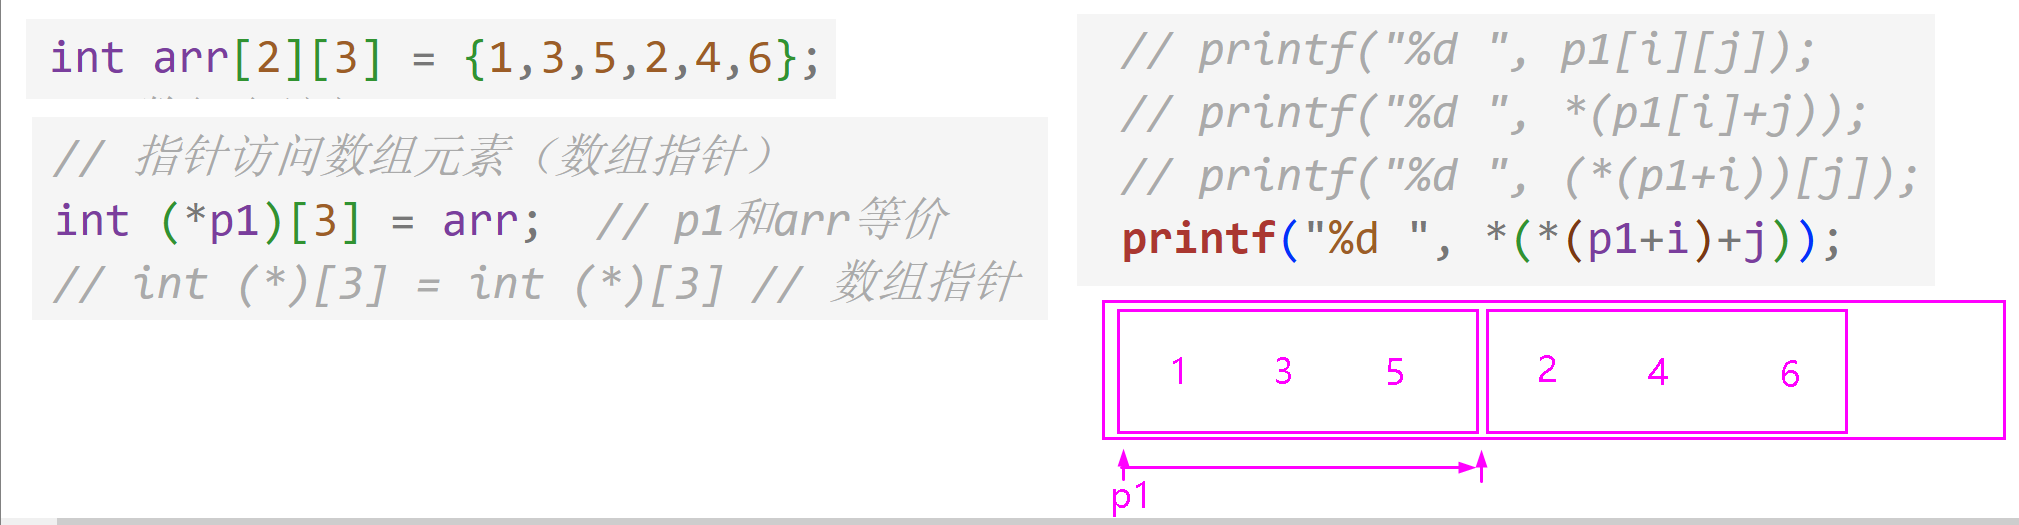
二维数组中,每一个元素类型是一个小数组类型,arr是数组名,是数组首元素地址,即类型为int (*)[3]
17-指针
指针(pointer):存储着地址的数据类型,地址也是一种变量
1)内存地址与基地址
字节:字节是内存的容量单位,英文:byte,一个字节有8 位,即1byte=8bits
地址:系统为了便于区分每一个字节而对他们进行逐一的编号,称为内存地址,简称地址
单字节数据:对于单字节数据而言,基地址就是其字节编号
多字节数据:对于多字节数据而言,基地址是其所有字节中编号最小的那个,称为基地址
2)指针运算符
指针相关运算符有两个,一个是*,另一个是&符号
对于*,有三种用法:
a)乘法运算符(双目),表示两个变量的乘积,例如a*b
b)做指针修饰,和基本数据类型一起修饰变量,例如int *p,此刻*和int一起修斯变量p,使得变量p变为一个整型指针,不再是整型变量,用来存储整型数据的地址
c)做解引用(单目),没有其他基本数据类型,例如*p,表示获取p存储的地址上的数据
对于&,两种用法:
a)位与(双目),表示对应bit位进行位与,全部为1,结果为1,否则为0
b)取地址(单目),表示获取某一个变量的地址,不能获取常量的地址
表格记录
1// 说法一:定义了指针类型变量p1,存储着变量a的地址
2// 说法二:定义了指针类型变量p1,指向a printf("a:%d\n", a); printf("a的地址:%#lx\n", &a);
3// 0x7ffcd491127c printf("p1的值:%p\n", p1);
4// 0x7ffcd491127c
5// 指针变量p1,确实存储着变量a的地址 printf("p1的地址:%p\n", &p1);
6// 0x7ffc6320f9b0
7
8
9### 表格记录
10
// *和&抵消 printf("a=%d\n", *&*&*&*&*&*&*&*&*&*&*&*&*&a);
3)指针的算术运算(偏移)
a)我们一般将指针的算术运算称为偏移,需要注意的是,指针的运算只能加减,不能乘除,语法不允许,
练习:定义不同类型的指针,然后对指针加一个单位
表格记录
1
2
3### 4)指针偏移量概念
4
5指针算术运算,可以和数组形式互相转换
6
7*(p+i) == p[i], 对所有的指针运算都成立,同时*(i+p) == i[p]
8
9要求这里的p是地址数据,
10
11请证明:数组名是首元素地址
12
5)指针与数组转换
练习:
使用尽可能多的方法,打印二维数组的元素
1
2### a)数组名访问数组元素:
3
4### 表格记录
5
// printf("%d ", *(arr[i]+j)); // printf("%d ", (*(arr+i))[j]); printf("%d ", *(*(arr+i)+j));
b)用指针访问数组(整型指针)
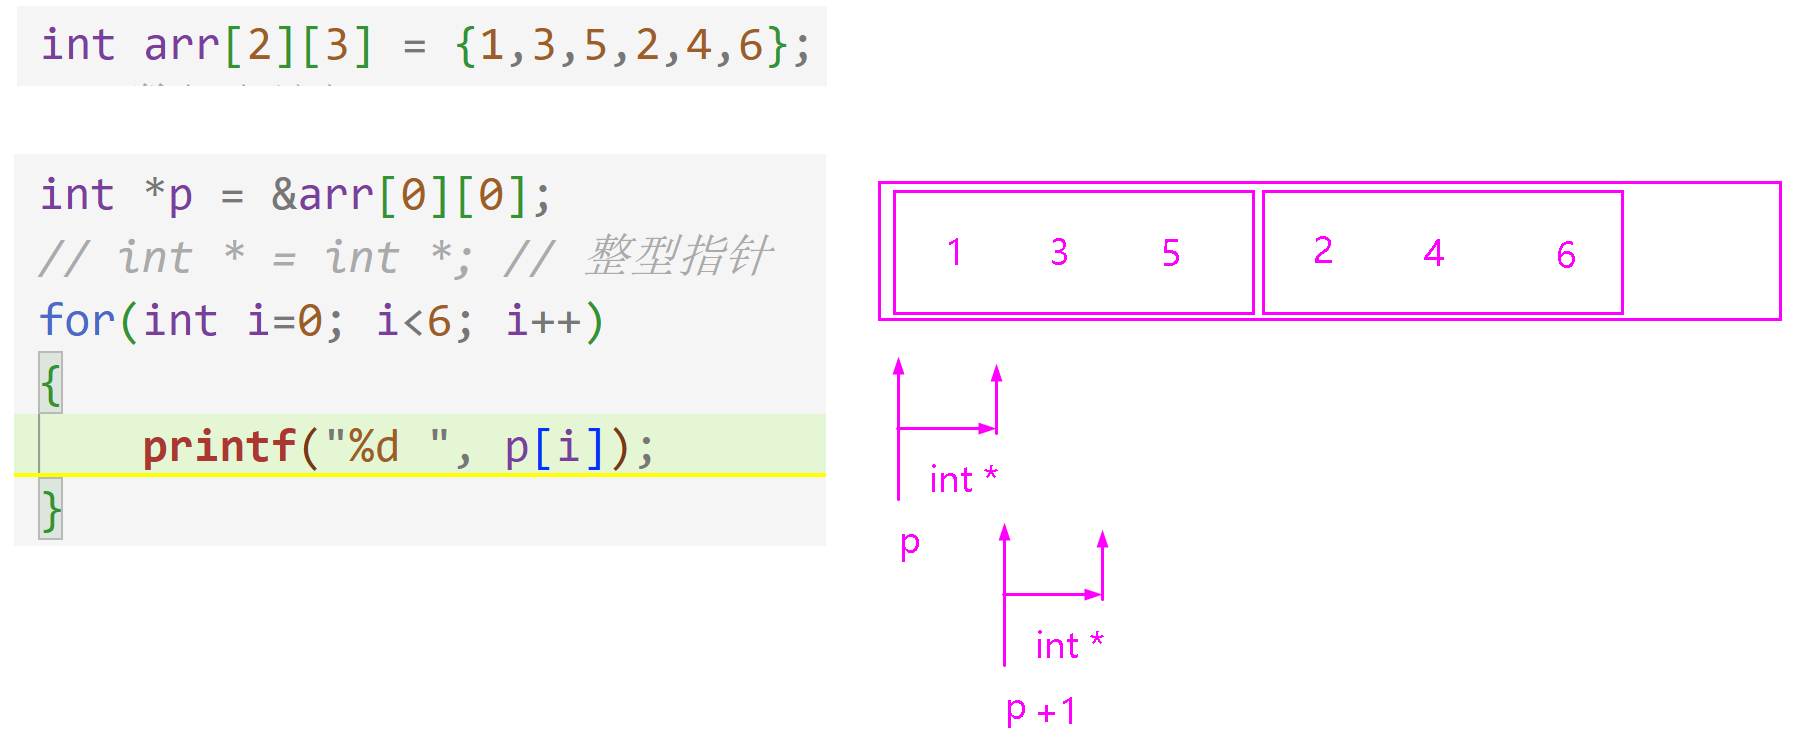
c)用指针访问数组(数组指针)
6)数组的地址和数组首元素地址
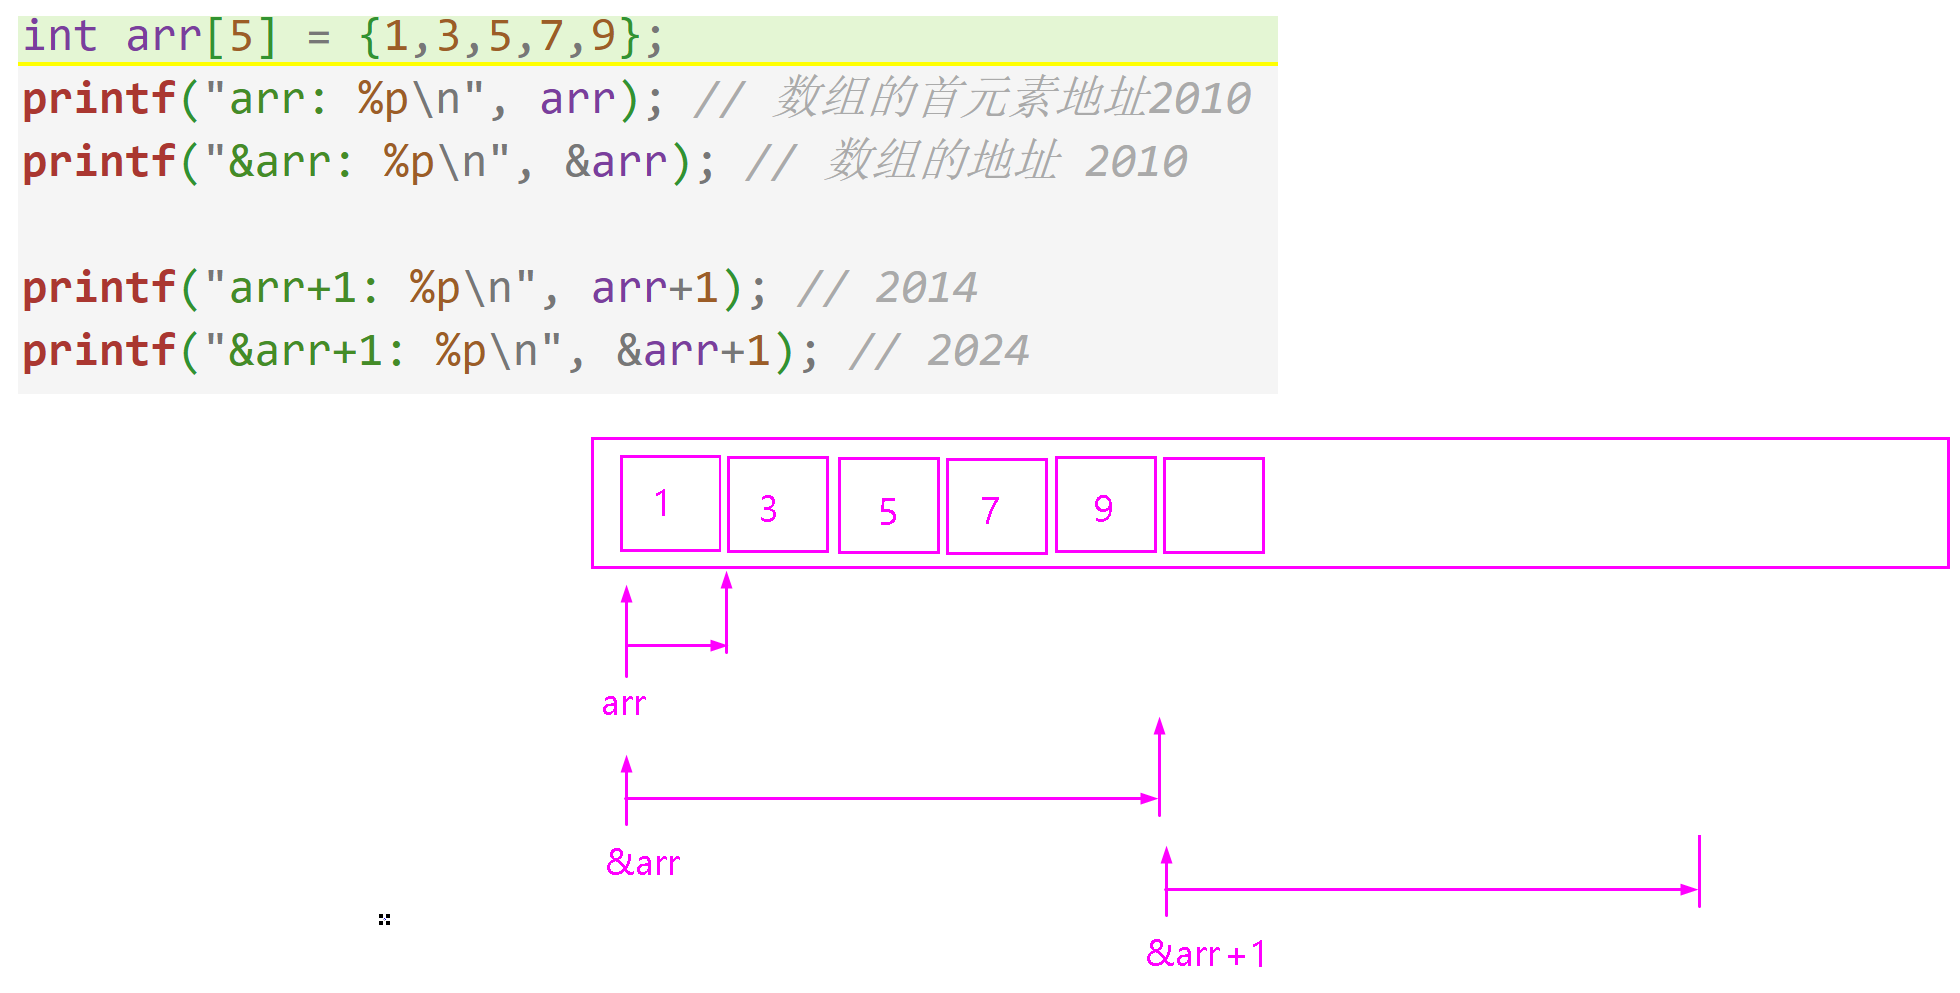
数组的地址和数组首元素的地址,在数值上相等,但是其表示的地址的范围是不同的,在算术运算中,偏移一个单位,所偏移的字节是是不同的
7)数组名相关概念
1.在定义数组,数组名前面有&,数组名在sizeof()中的时候,表示的是整个数组,其他的时候,表示的都是数组首元素地址
2.对数组的地址解引用,得到数组的首元素地址
3.数组首元素的地址和数组本身的地址,在数值上是一样的,但是地址的类型不一样
8)指针的左值和右值
a)左值必须是一个可被存储的单元,右值是一个可被读取的数据
b)左值必须是一个被明确了的内存存储单元,可以用来被赋值,右值代表了数据本身
案例:
1.不能对常量赋值:
1
22.不能对只读变量赋值:
3
i=200; int a=10, b=20, c=30; int *p1=&a, *p2=&b, *p3=&c;
a. a=b; 等号左边表示a的内存单元,等号右侧表示b的内存中的数据20
b. *p1 = *p2;等号左侧表示a的内存单元,等号右侧表示b内存中的数据20
c. p2=p3;等号左侧表示p2的内存单元,等号右侧表示p3的内存的地址数据c的地址
18-复杂类型声明
1)数组指针,指针数组,函数指针,指针函数
以上内容都是不一样的,重点在最后两个字,其他的都是修饰,搞清楚常出现的名称的作用
指针:指针是做指向的,指向某一个对象
数组:数组是做存储的,存储某一个对象
函数:一般关注返回值,
(1)数组指针。(行指针,指向二维数组的一行数据)
指针数组的指针,叫做数组指针
1
2这个指针的作用:指向int [5]这样的小数组,一般用于二维数组的访问
3
4### (2)指针数组。(数组三要素:连续内存,相同类型,具体长度)
5
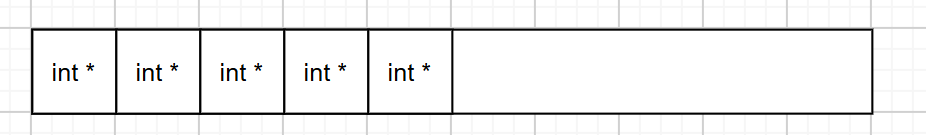
大小40 字节
作用:如果需要多个指针指向多个数据, 并且这些指针的类型相同,那么就可以使用指针数组批量管理这些指针
因为在c语言中,字符串表示可以使用char *,所以将char*和指针数组结合
(3)函数指针(指向函数的地址)
1
2// 函数的类型由返回值类型+参数列表组成
3
printf("sum=%d\n",p(a, b));
在虚拟地址中,没有办法给一个实际的物理地址,那么在stm32等设备中,就可以给某些具有特定功能的地址,用指针指向,然后使用指针调用,
案例:int (*p)(int, int) = 0x0000FFFF;然后使用p调用
应用:回调函数
(4)指针函数(返回值为指针的函数/返回了地址)
函数在返回地址的时候,要注意,如果该地址是子函数内部定义的局部变量的地址,那么在返回的瞬间,变量所对应的数据都被系统回收,不能再获取数据,
函数传参时,使用值传递,返回就算返回地址,也不能获取数据,使用地址传递时,形参和实参用的是同一块地址,返回这块地址的时候,不会被销毁,
练习:
1.定义一个指针数组,尝试通过其中的指针去交换两个变量的值
1
22.定义一个指针数组,尝试通过其中的指针去调用以下两个函数
3
int func_sub(int a, int b); // a-b
3.定义两个变量a和b,然后写一个func_swap(), 在该函数中,交换两个变量的值,要求,子函数中交换后,主函数中的a和b的值也发生交换
(5)回调函数
软件分层设计,不同软件模块的开发进度可以独立出来,
普通函数调用:main()--->子函数----》返回,
回调函数:在调用子函数的时候,指定子函数调用的对象
表格记录
1// 服务员 int func_working(int a, int b, int (*p)(int, int)) { a--; b++; return p(a, b); }
2// 主函数 int main(int argc, char const *argv[]) { int a=10, b=11; int ret = func_working(a, b, func_cooking4); printf("ret = %d\n", ret); }
3
4
5### (6)多级指针的应用
6
7练习:
8
91.在main函数中定义一个数组和一个指针
10
int *p = arr;
编写一个函数func_move(), 作用是将指针p修改为指向数据5,在main函数中,通过指针p访问,并打印其指向的数据
表格记录
1// p1存储的是main函数中,指针p的地址 {
2// *p1 是main函数中,p的值,即arr[0]的地址
3// **p1 是main函数中,p指向的数据
4// 移动指针 *p1=*p1+2;
5// p的值,被修改为arr[2]的地址,即p指向5 printf("func:**p1=%d\n", **p1);
6// 5 } int main(int argc, char const *argv[]) { int arr[5] = {1,3,5,7,9}; int *p = arr; func_move(p);
7// 传递的是1的地址,并不是p的地址,所以对地址的修改,不能影响p printf("main:*p=%d\n", *p);
8// 1 func_move1(&p);
9// 修改p的指向,需要传递p的地址 printf("main:*p=%d\n", *p);
10// 1 return 0; }
11
12
13### (7)空指针与野指针与空悬指针
14
15空指针:
16
17指向NULL的指针,称为空指针
18
NULL等价于0x0000 0000
NULL代表的这块地址不可访问,如果访问就会出现段错误
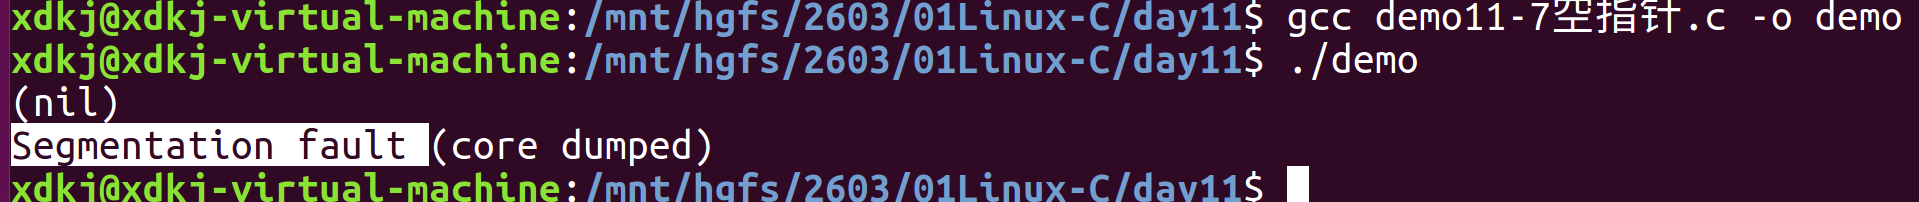
Segmentation fault (core dumped) 即段错误,编译的时候,不会提示,只有运行的时候会报错,
段错误出现原因:
非法内存操作,访问了不可访问区域,访问越界,内存溢出,……
解决办法:在关键的代码语句位置,添加打印语句,找出错误的代码行
野指针:指向不明确的指针,被称为野指针,任意使用,可能导致不可预料的错误,
所以,在操作中,如果定义了指针,没有明确指向,最好让指针指向NULL,因为就算对NULL访问,造成段错误,也不会覆盖重要数据,数据是无价,
空悬指针:指针指向的内存,被系统回收或者手动释放,一旦释放或者回收,该内存就是未申请的,内存空间,不可访问,一般对空悬指针,会让其重新指向NULL
(9)指针的应用:字符串
字符串常量可以存储在字符数组中,也可以把字符的首元素的地址,存储在char *指针中
表格记录
1// 将字符串hello存储在数组中 char *p = "hello";
2// 将字符串中'h'的地址,给p
3// 将hello,换成hbllo str[1] = 'b'; printf("str=%s\n", str);
4// *(p+1) = 'b';
5// 段错误
6// p存储的是字符串常量hello的h的地址,*(p+1) = 'b',相当于
7// 修改常量,常量不能被修改,强制修改就会报段错误 printf("p=%s\n", p);
8
9
10### 补充:字符串操作相关的函数接口
11
12(1)计算字符串的长度
13
函数原型:计算字符串的长度,不包括字符串结尾标志,'\0'
1
2参数:
3
返回值:
成功:返回字符串的长度(不包含'\0')
备注:
sizeof和strlen的区别
(1)sizeof是运算符,strlen是函数
(2)sizeof可以计算变量,或者数据类型所占内存的大小
(3)strlen只能计算字符串的长度,
(4)在计算字符串对象时,sizeof包含’\0‘, strlen计算的时候,不包含
(2)拷贝字符串到指定位置
1
2函数接口
3
// 将src的字符串,拷贝到dest中 char *strncpy(char *dest, const char *src, size_t n); // 将src的前n个字节,拷贝到dest中,
参数:
1const char *src, 源字符串
2size_t n n个字节
3
4返回值:
5
6成功:返回指向dest的指针,
7
8练习:利用自己的代码,实现strncpy
9
10(3)比较两个字符串是否相等
11
函数原型:// 从第一个字符开始比较,只要不相同就结束
1int strncmp(const char *s1, const char *s2, size_t n);
2// 比较s1,s2的前n个字符
3
4参数:
5
const char *s2, // 参与比较的第二个字符串 size_t n // 需要比较的前n个字节
返回值:
成功:看s1和s2不同的字符在ASCII码上的差值是多少就返回多少
// 使用s1的ASCII的十进制的值,减s2的ASCII的十进制的值
练习:利用自己的代码,使用strncmp
(4)拼接两个字符串
1
2函数原型:将src的字符串拼接到dest之后,覆盖掉dest的'\0',最后会补'\0'
3
char *strncat(char *dest, const char *src, size_t n); // 把src的前n个拷贝到dest
参数:
1const char *src, 源字符串
2size_t n 需要拼接的前n个字符
3
4返回值:
5
6指向dest的指针
7
8练习:
9
10输入一个字符串,查看该字符串是否为“Tom”,如果是,将Tom和help拼接,然后输出help Tom,如果不是,将Tom覆盖掉,然后输出,“REEOR”
11
12## 19-Linux内存布局
13
14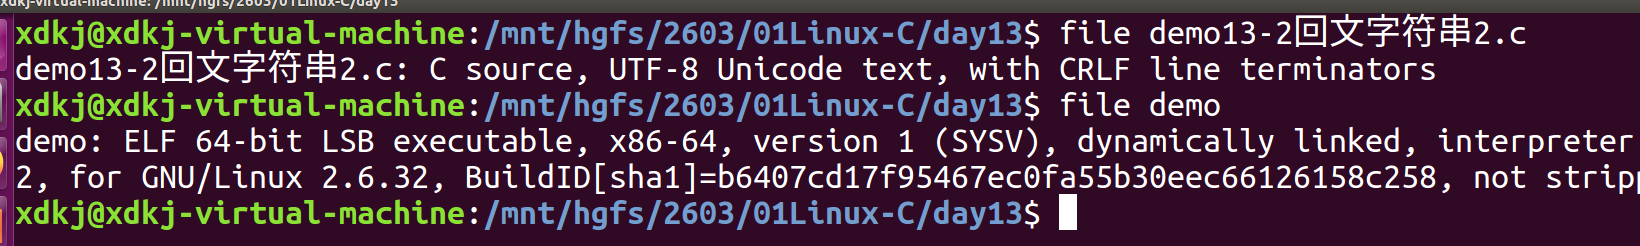
15
16ELF:Linux系统下,可执行文件(专业名词: 可重定位文件)
17
18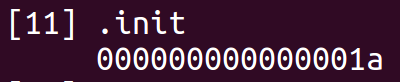
19
20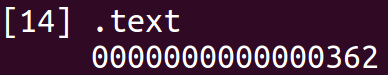
21
22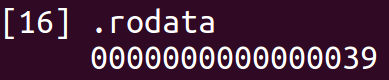
23
24
25
26
27
28虚拟内存的内容:
29
30内核,栈,堆,数据段,代码段,不可访问区
31
32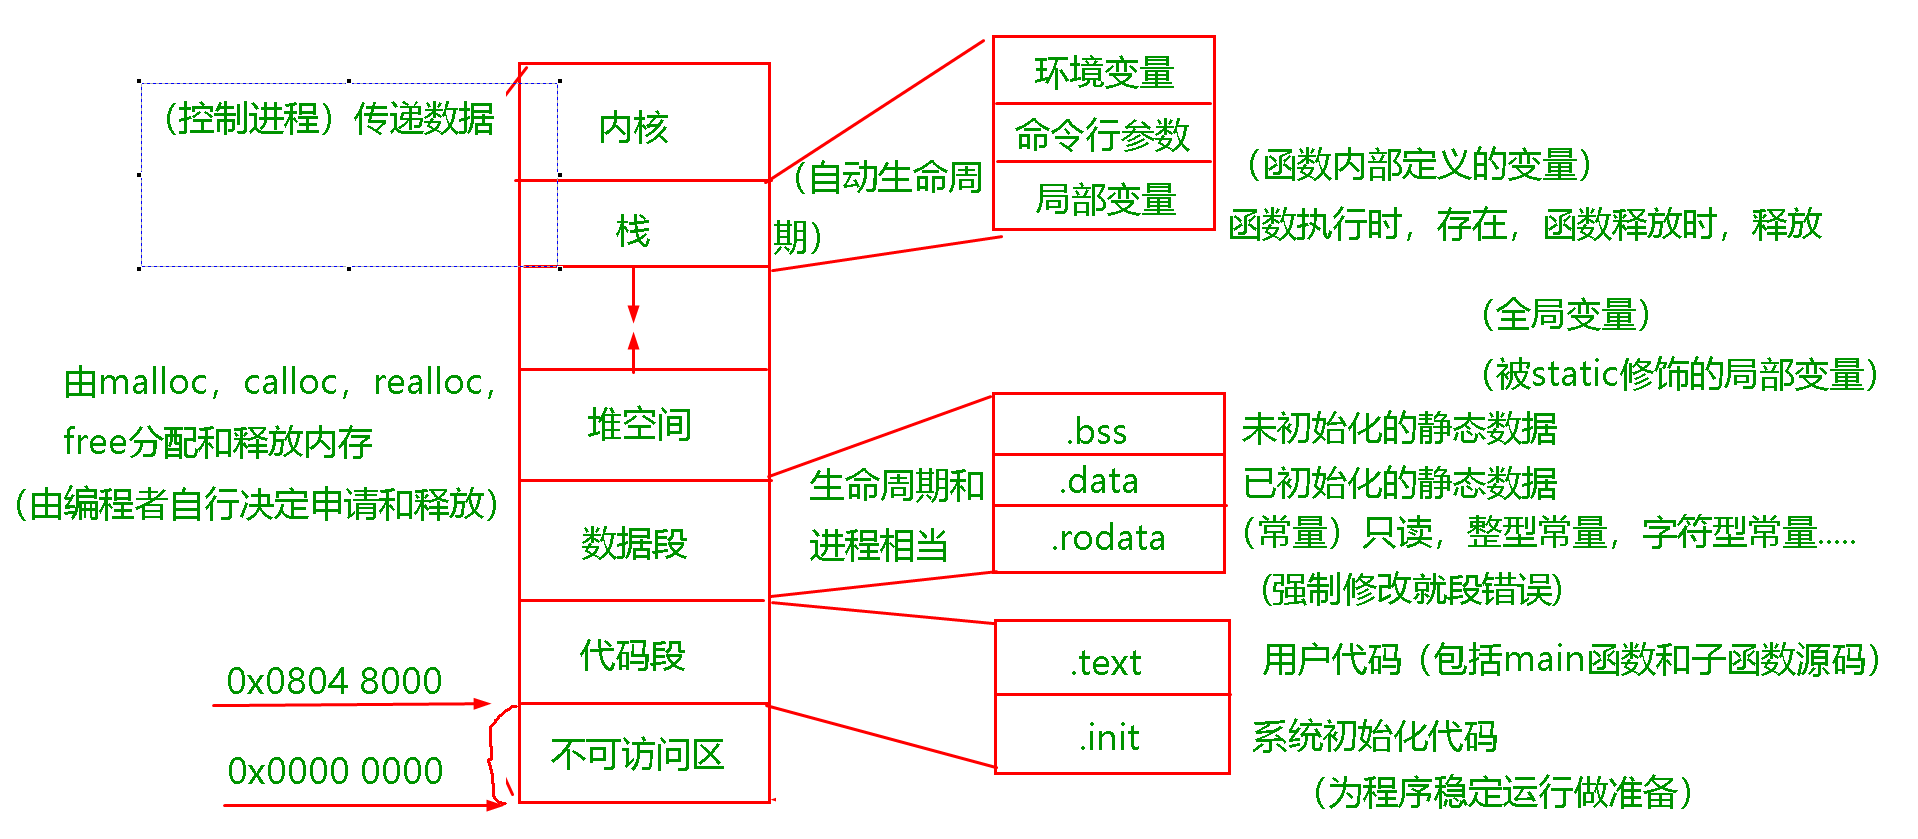
33
34函数外部定义的变量是全局变量,所有的函数和文件都可以使用
35
36除了全局变量位于静态数据段,还有被static修饰的局部变量也会在静态数据段,静态数据段中的数据,如果没有进行初始化,会自动初始化为0,
37
38函数内部定义的变量,称为局部变量,如果没有初始化,其值是一个随机值,
39
40不要滥用静态数据,因为静态数据的生命周期和进程相当,会一直占用内存,在多线程编程中,可能造成资源共享出现问题
41
42### 补充:static
43
44修饰局部变量:
45
46使得局部变量,由栈空间转移到静态数据段,生命周期变为和进程相当,在操作上,如果没有初始化,会被初始化为0,并且只有一次初始化有效
47
48修饰全局变量和函数
49
50将该变量和函数的链接类型,由外部链接,修改为內部类型,内部和外部指的是文件
51
52static修饰全局变量和函数后,该变量和函数只能在本文件中使用,这样可以在实际开发中,解决变量重名问题(例如两个文件中,使用了相同名称的全局变量),
53
54### 补充:volatile
55
561)概念
57
58“易变”是因为外在因素,比如在中断,多线程的时候,volatile提醒编译器,他后面所定义的变量随时都有可能被修改,因此编译后的程序每次都需要存储或者读取这个变量的时候,告诉编译器对该变量不做优化,都会直接从变量内存地址中读取数据,从而可以提供对特殊地址的稳定访问
59
60### 补充:auto和register
61
621)auto自动化变量(内存变量);定义变量时,该关键字可以省略不写
63
比如:int a——》全称signed int a;// 一般默认signed 不写
2)register 寄存器变量
调用频繁的变量,可以定义成一个寄存器变量
注意:
- 定义寄存器变量不一定成功(主要看编译器),如果不成功会自定义成自动化变量
-寄存器变量没有内存地址,所以不能取地址
补充:编码规范
常见的标识符命名方法
(1)驼峰命名法
1)小驼峰命名法
第一个单词的首字母小写,后续单词的首字符大写
优点:清晰易读,适用于变量名和函数名
studentName
2)大驼峰命名法
所有的单词首字符都大写
优点:清晰易读,通常用于类名和结构体名
StudentName
(2)下划线命名法
1)小写下划线命名法
所有单词小写,单词之间用下划线链接
优点:适用于变量名和函数名,是c中最常见的命名方法
student_name
2)大写下划线命名法
所有单词都大写,单词之间用下划线链接
优点:适用于宏和常量
STUDEN_NAME
(3)匈牙利命名法
在标识符前面加上一个或者多个前缀,表示变量的类型或者用途
优点:可以提供关于变量的额外的信息,有助于理解变量的用途
strName
(4)前缀命名法
在标识符前面加上一个特定的前缀,以表示其所属的模块或者作用域
优点:有助于避免命冲突,特别是在大型项目或者库中
my_strlen
(5)后缀命名法
在标识符的后面加上一个特定的后缀,以表示其类型或者用途
优点:可以提供关于变量类型的额外信息
countVal
(6)混合命名法
结合多种命名方法的特点,根据具体的需求进行命名
studentNameStr
20-堆空间申请和释放
练习:
申请10MB的栈空间,使用指针p指向该空间,然后存入一个字符'A',然后打印
操作会段错误,因为栈空间默认只有8MB,
当需要较大的内存空间时,尽量使用堆空间,
1
2函数原型:堆空间操作相关函数
3
void free(void *ptr); // 释放堆空间 void *calloc(size_t nmemb, size_t size); // 申请nmemb*size大小的堆空间 void *realloc(void *ptr, size_t size); // 对ptr指向的堆空间,重新申请大小为size
参数:
1void *ptr 指向已经申请的堆空间(堆空间首地址)
2size_t nmemb (块)
3
4返回值:
5
6成功:返回指向堆空间的指针
7
8失败:NULL
9
10练习:
11
12编写一个申请堆空间的函数heap_request(), 该函数返回堆空间的地址,在main函数中,调用这个子函数,申请1个堆空间,然后往里面存储5个int型数据,然后打印出来
13
14## 21-结构体
15
16如果需要描述一个复杂的对象,该对象有不同的数据类型,此时可以使用结构体,
17
18### 1)结构体含义:
19
20一整块连续的内存,其中包含任意数据类型(不能包含函数),可以存放相同类型,也可以存放不同类型
21
22案例:
23
24### 2)结构体的使用:
25
26一般在使用结构体之前,需要构造一个结构体模板,或者叫做声明一种结构体类型
27
28### 表格记录
29
// 成员1:char [32]类型的数组 int age; // 成员2:int 整型 float score; // 成员3:float 浮点型 }; //struct:结构体关键字 //student:结构体标签 //{...}: 结构体成员
3)结构体变量的定义
(1)构造结构体模板的时候,定义变量
表格记录
1
2
3
4### (2)先构造模板,后定义变量
5
6定义变量的时候,一定是关键字+标签然后加变量名
7
8### (3)缺少标签,但是有typedef对结构体模板取别名,然后可以使用别名定义结构体变量
9
10### 表格记录
11
// stu不是结构体变量名,是该结构体的类型别名
4)结构体变量的初始化
(1)先定义,后初始化
表格记录
1// 初始化
2// first.name = "Tom"; 数组名不能做等号左值 strcpy(first.name, "Tom"); first.age = 10; first.score = 98.5;
3
4
5
6### (2)定义并初始化,按照顺序
7
8### 表格记录
9
(3)指定成员初始化
表格记录
1
2
3
4### 5)结构体指针
5
6### 表格记录
7
// 与上一行等价
结构体指针,在引用成员时,使用->
普通的结构体变量,在引用成员时,使用.
->和. 属于分量运算符,需要注意的是,一般结构体指针都是用->,不会先解引用在使用.
练习:
1.声明一个结构体类型
成员1:学号 int
成员2:姓名 char [32]
成员3:性别 char
成员4:分数 float
成员5:地址 char *
要求:
1)定义一个结构体变量,初始化如下内容
1 Tom m 98.7 武汉
初始化以后,打印到屏幕上,要求打印效果如下:
Id Name Sex Score Addr
1 Tom m 98.7 武汉
2)定义一个拥有50个元素的结构体数组,初始化其中3个学生的信息,然后编写一个show_array()函数,打印结构体数组中的有效元素,效果如下
Id Name Sex Score Addr
1 Tom m 98.7 武汉
2 Rose w 77.8 湖北
3 Jerry m 60 洪山区
6)结构体大小
地址对齐
变量的地址对齐概念:我们常说的操作系统32 位或者64 位,指的是CPU一次能够操作的最大bit位,对一个变量进行操作的时候,CPU更希望从内存中,操作一次就能够获取该变量的所有数据,因为这样可以提高CPU操作效率,所以,在定义变量的时候,虽然地址是系统随机分配的,但是系统是按照一定的规则进行分配的,该规则为地址对齐整数倍m规则
表格记录
| 项目 | 32 位 | 64 位 | | --- | --- | --- | | 地址对齐,地址的m倍规则 | 32 位(m的值) | 64 位(m的值) | | char | 1 | 1 | | short | 2 | 2 | | int | 4 | 4 | | long | 4 | 8 | | long long | 4 | 8 | | 指针 | 4 | 8 | | float | 4 | 4 | | double | 4 | 8 |
22-共用体 (联合体)
关键字:union,他与结构体的操作类似,但是没有结构体使用频率高,因为其自身有局限性
特点:内存共用,操作互斥
表格记录
1// union:关键字
2// example:标签
3// {...}: 共用体成员 int main(int argc, char const *argv[]) {
4// 计算共用体模板的大小 printf("%ld\n", sizeof(union example));
5// 8 字节 union example tmp = {.a = 100}; printf("a=%d\n", tmp.a);
6// 100 printf("b=%d\n", tmp.b);
7// 100 return 0; }
8
9
10## 23-枚举
11
12枚举是c语言中的一种基本数据类型,它可以让数据更简洁,更易读,他在c语言中就是纯粹的整型
13
14枚举的格式:
15
枚举元素1,枚举元素2,…… // 注意,各个元素之间用逗号隔开
1
2备注:
3
4如果没有指定枚举列表中的整数的值,会默认从0开始递增
5
6如果指定某一个元素的值,其后的元素的值,依此递增
7
8枚举在很多场合被宏定义代替了
9
10## 补充:attribute机制
11
12在GNU的扩展语法中,有一个特殊的attribute机制(属性),它可以对函数、变量和数据的各种属性做设置,
13
14格式:
15
16声明 __attribute__((attribute-list)) 对象; 注意attribute前后有两个下划线,属性列表必须加额外的括号
17
18案例1:int __attribute__(()) a;attributte修饰变量a,因为属性列表为空,所以属性忽略
19
20案例2:int __attribute__((packed)) a, 将变量a的地址调整按照1 字节对齐
21
22案例3:int __attribute__((aligned(num))); 将变量a的地址调整为按num字节对齐,num=2的n次方,n为正整数
23
24## 补充:结构体的位域操作
25
26位字段,允许你将一个整数类型的数据分割为多个位段(bits),并为每一个位段分配特定数量的bit位数,应用在需要节省内存,访问硬件寄存器等场合(只能用于整型数据)
27
28案例1:利用各个bit位做开关
29
30案例2:位字段在不同数据之间使用(结构体的大小,要看分配的bit位的和,以及成员中,最大的m值)
31
32案例3:无名位域bit位为0,下一个位域将强制从下一个数据类型开始,无名位域bit位非0,标识占用对应的bit位,但是不能使用,没有无名位域时,只有剩余的bit位不够分的时候,才从下一个字节获取bit位,
33
34## 补充:零长数组
35
-用途:放在结构体的末尾,作为可变长度数据的入口
-案例:
表格记录
1// 定义结构体指针,并且为结构体分配额外的10个字节内存 struct data *p = malloc(sizeof(struct data)+10); printf("size=%ld\n", sizeof(struct data)); p->len = 10;
2// 额外的空间;
3// data[0]~data[9] p->data[0] = 'a'; printf("%c\n", p->data[0]); return 0; }
4
5
6
7## 24-编译器gcc
8
9### 1)编译器的作用
10
11将代码文本编译为机器能够识别的二进制指令
12
13### 2)编译的过程
14
15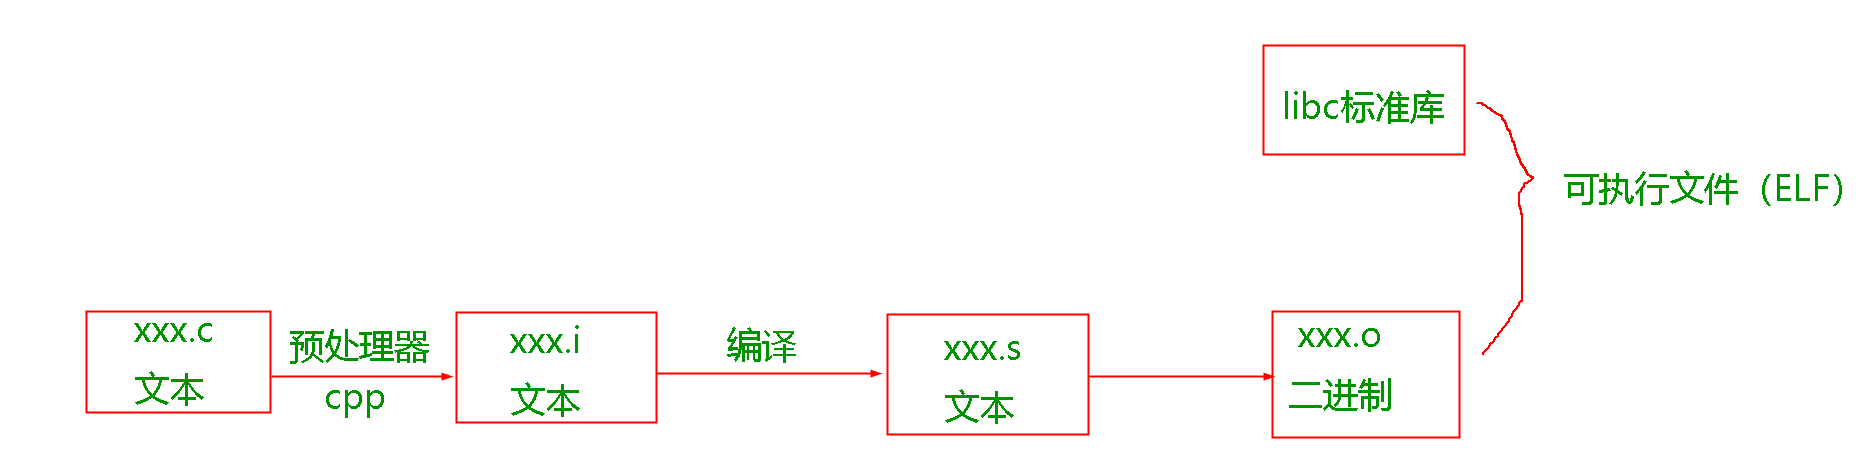
16
17(1)预处理:(代码文本---->预处理文本)
18
19指令:gcc xxx.c -o xxx.i -E
20
21作用:处理所有的预处理指令(以#开头,比如头文件包含,宏定义,条件编译等等),屏蔽注释
22
23(2)编译:(预处理文本---->汇编文件)
24
25指令:gcc xxx.i -o xxx.s -S
26
27作用:词法、语法分析,根据不同平台生成最接近的汇编语言
28
29(3)汇编:(汇编文件---->ELF可重定位文件)
30
31指令:gcc xxx.s -o xxx.o -c
32
33作用:将汇编指令翻译为可直接运行的二进制指令流
34
35(4)链接:(ELF可重定位文件+库连接--->最终程序)
36
37指令:gcc xxx.o -o demo -lc -lgcc (-lxxx:表示链接xxx库)
38
39作用:重定位(函数和全局变量),链接库,合并段
40
41问题:
42
431)代码经过哪个步骤后,程序员看不懂,---- 汇编
44
452)提示错误行号,出现在哪一个步骤?-------编译
46
473)为什么函数未定义的时候,不报错误行号?-对函数的定位属于链接阶段,提示错误行号在编译阶段,所以不会有行号提示
48
49总结:
50
511)汇编阶段,是处理汇编文件,不是生成汇编文件
52
532)-lxxx,表示链接某一个库,-I(大写的i)/路径,指定使用了某一个头文件的路径
54
553)预处理阶段不会对语法词法进行分析,不会报错
56
57### 3)预处理指令
58
59在源码中,以#开头的语句,被称为预处理指令,他们不属于普通的c语言语法
60
61### (一)宏定义:#define
62
63概念:c语言中的宏定义是一种预处理指令,他允许开发者为一段代码或者值定义一个名称,称为宏,在程序编译时,预处理器会在实现编译之前,对源代码进行处理,将宏替换为其定义的内容,宏定义通常大写,用于和普通的变量和标识符进行区分。
64
65### 表格记录
66
格式: 带参数的宏定义(宏函数) #define <宏名>(参数列表) <宏体> #define xxx(x,y) ({}) #define IS_EVEN(x) ((x)%2==0) #define PRINT_NUM(n) do{ \ int i; \ for(i=0; i<(n); i++){ \ if(IS_EVEN(i)){ \ printf("%d is even\n", i); \ }else { \ printf("%d is odd\n", i); \ } \ } \ }while(0) #define MIN(a, b) ((a)<(b)?(a):(b)) #define SWAP(a, b, tmp) do{ \ tmp = (a); \ (a) = (b); \ (b) = tmp; \ }while(0) #define SQUARE(x) ((x)*(x)) #define AREA_OF_CIRCLE(r) (3.14*SQUARE(r)) 1)预处理日期和时间 __DATE__, __TIME__ 2)函数名和当前行 __FUNCTION__, __LINE__ 3)文件名 __FILE__
补充:工程代码组织
在一个较小的工程中,一般代码不会全部都写在main函数中,一般会拆分为好几个c文件以及一个头文件,
其中,main.c中,只保留主逻辑,其他的c文件,根据功能分类来拆分,头文件放共有资源
如果头文件被多个c文件包含,并且头文件中有全局变量,那么该全局变量不能初始化
头文件中,可以包含的共有资源
公共头文件,函数声明,全局变量,结构模板,共用体模板,枚举,宏定义,宏函数,内联函数,
如果有某一个c文件中,有全局变量,且必须有初始化,那么可以在该c文件中,定义,在公共头文件中声明,然后该头文件被其他c文件引用,则其他的c文件中,都可以使用刚刚定义的变量
练习:
创建一个工程文件夹project,里面有main.c,有func.c,还有一个head.h,main.c中输入两个变量a和b的值,然后在func.c中有分别计算加减乘除的函数接口,在main函数中,调用这些接口,然后把计算的结果,在main.c中,打印出来
(九)内联函数
1.概念:类似于宏替换,是由inline修饰的函数,意指:当编译器发现某一个代码段在调用一个内联函数时,他不是去调用该函数,而是将该函数的代码,整段的插入到当前位置,这样做的好处就是省去了调用过程,加快程序的运行速度
2.什么时候用内联函数
a)函数代码简答
b)函数被频繁调用
3.注意
a)内联函数实际上是用空间代价(程序的尺寸增大)来换取时间效率(不再需要切换函数)
b)内联函数定义一般在头文件中
c)内联函数代码块一般不超过5行
d)内联函数函数体中,不能有循环语句,if语句或者switch语句,否则函数定义时即使有inline关键字,编译器也会把该函数作为非内联函数处理
e)内联函数要在函数被调用之前声明,关键字inline必须与函数定义体放在一起才能使函数成为内联函数,仅仅将inline放在函数声明之前是不起任何作用的,而且内联函数在声明阶段也要加上inline关键字
f)内联函数在编译阶段被处理,inline关键字只是建议,具体是否被展开到代码中,由编译器决定
4.内联函数和宏函数的区别
1.编译处理
宏函数:在预处理阶段由预处理器处理,宏函数没有类型检查,没有作用域,只是简单的文本替换
内联函数:内联函数在编译时被处理,编译器会在调用内联函数的地方直接插入或者替换内联函数的代码,从而避免函数调用的开销,内联函数有类型检查,也有作用域
2.参数处理
宏函数:由于宏函数只是文本替换,因此参数在替换过程中可能会引发一些意料之外的问题,比如运算符优先级问题,为了避免这些问题,宏函数的参数通常需要使用括号包围
内联函数:内联函数在参数处理上就像普通函数一样,有明确的参数类型和参数传递方式,因此不需要担心运算符优先级问题
3.调试和可读性
宏函数:可能会降低代码的可读性和可维护性
内联函数:可以提高代码的可读性和可维护性
4.适用场景
宏函数:通常用于执行简单的,不需要复杂逻辑或类型检查的操作,或者用于定义一些常量或者简单的计算
内联函数:使用于函数体较小,但又被频繁调用的函数,通过内联函数可以减少函数的调用开销,提高程序的执行效率
(十)变参宏
表格记录
1
2
3## 25-大小端序
4
5在计算机中,基本单位是字节,所以当一个变量的内存大于一个字节的时候,在存储上就有两种方式,
6
7数据的高位存储在地址的高位,数据的低位存储在地址的低位上-----小端序
8
9数据的高位存储在地址的低位,数据的低位存储在地址的高位上-----大端序
10
11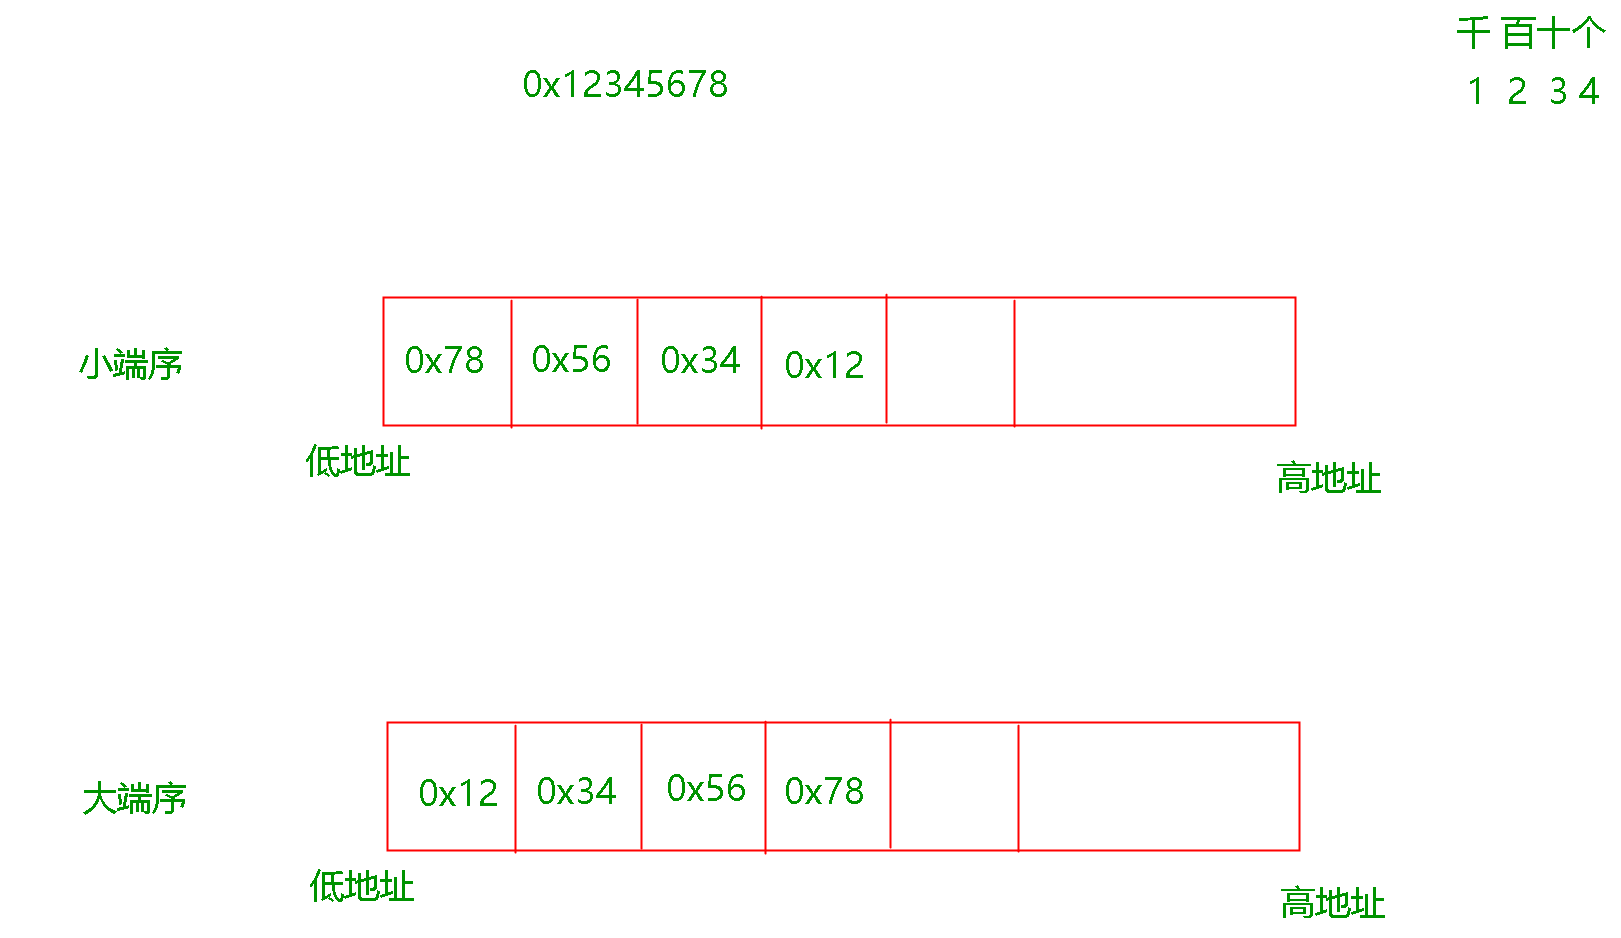
12
13案例:测试大小端序
14
15(1)共用体法
16
17### 表格记录
18
// 0x34 return 0; } short a = 0x1234; char *p = (char *)&a; printf("%#hhx\n", *p); printf("%#hhx\n", *(p+1));
26-变参函数
补充:在格式控制符中,宽度或者精度可以使用*表示,然后,宽度或者精度的值通过转换下一个参数(必须为int类型)来计算
表格记录
1// *被max替换,控制输出的字符个数 printf("%.*s\n", max, "helloworld");
2
3
4
5### 表格记录
6
// 固定参数至少得有一个 { va_list 指针变量p; // 定义一个va_list类型的变量,用于访问变参 va_start(指针变量p,固定参数n);// 初始化va_list,指定最后一个固定参数 初始化指针变量p,指向变参的起始地址; 变参前的最后一个固定参数 使用va_arg(指针变量p,参数类型) 宏获取变参 获取变参列表的下一个参数,并指定其类型 每次调用函数,会将指针p指向下一个参数 va_end(指针变量p);// 清理va_list,结束对变参的访问 }
27-符号
#符号,##符号
表格记录
1// helloworld
2
3
4
5### 表格记录
6
// 将文本STR转为字符串 int main(int argc, char const *argv[]) { // 将非字符串:ikun i love you转为字符串"ikun i love you"给%s printf("CHANGES(STR)=%s\n", CHANGES(ikun i love you)); return 0; }
COMMENTS
讨论
还没有公开评论。欢迎留下你的想法。